| Topic 30 | การแปลงข้อมูลเปลี่ยนวิธีเขียนโปรแกรม |
|---|
ถ้าคุณไม่สามารถอธิบายสิ่งที่คุณกำลังทำในฐานะ Process ได้ แสดงว่าคุณยังไม่รู้ว่าตัวเองกำลังทำอะไรอยู่
W. Edwards Deming , (attr)
โปรแกรมทุกตัวทำหน้าที่แปลงข้อมูล (Transform Data) คือแปลง Input ให้กลายเป็น Output แต่พอพูดถึงเรื่อง Design เรากลับแทบไม่เคยคิดถึงการสร้าง Transformation เลย เรามัวแต่กังวลเรื่อง Class และ Module, Data Structure และ Algorithm, Language และ Framework กันซะมากกว่าครับ
เรามองว่าการโฟกัสที่ Code แบบนี้มักจะพลาดประเด็นสำคัญไป เราจำเป็นต้องกลับไปคิดว่าโปรแกรมคือสิ่งที่แปลง Input ให้กลายเป็น Output พอเราทำแบบนั้น รายละเอียดจุกจิกที่เราเคยกังวลก็จะหายไปเองเยอะเลยครับ โครงสร้างจะชัดเจนขึ้น การจัดการ Error จะสอดคล้องกันมากขึ้น และ Coupling ก็จะลดลงไปมาก
เพื่อเริ่มต้นการสำรวจ ลองนั่ง Time Machine ย้อนกลับไปในยุค 1970s แล้วขอให้ Unix Programmer เขียนโปรแกรมที่แสดงรายชื่อไฟล์ 5 ไฟล์ที่ยาวที่สุดใน Directory Tree ให้เราดูกันดีกว่าครับ โดยคำว่า "ยาวที่สุด" ในที่นี้หมายถึง "มีจำนวนบรรทัดมากที่สุด"
คุณอาจจะคิดว่าเขาจะหยิบ Editor ขึ้นมาแล้วเริ่มพิมพ์โค้ดภาษา C แต่เขาจะไม่ทำแบบนั้นครับ เพราะเขาคิดถึงเรื่องนี้ในรูปแบบของสิ่งที่เรามีอยู่ (Directory Tree) กับสิ่งที่เราต้องการ (รายการไฟล์) แล้วเขาก็จะไปที่ Terminal แล้วพิมพ์อะไรประมาณนี้ครับ:
| | $ find . -type f | xargs wc -l | sort -n | tail -5 |
|---|
นี่คือชุดของ Transformation ที่ต่อเนื่องกันครับ:
find . -type f
เขียนรายการไฟล์ทั้งหมด ( -type f ) ที่อยู่ใน Directory ปัจจุบันหรือต่ำกว่าลงไป ( . ) ไปยัง Standard Output
xargs wc -l
อ่านบรรทัดต่างๆ จาก Standard Input แล้วจัดการส่งพวกมันทั้งหมดเป็น Argument ให้กับคำสั่ง wc -l โปรแกรม wc ที่ใช้ Option -l จะนับจำนวนบรรทัดในแต่ละ Argument แล้วเขียนผลลัพธ์แต่ละอันออกมาในรูปแบบ “count filename” ไปยัง Standard Output
sort -n
เรียงลำดับ Standard Input โดยสมมติว่าแต่ละบรรทัดขึ้นต้นด้วยตัวเลข ( -n ) แล้วเขียนผลลัพธ์ไปยัง Standard Output
tail -5
อ่าน Standard Input แล้วเขียนเฉพาะ 5 บรรทัดสุดท้ายไปยัง Standard Output
ลองรันคำสั่งนี้ใน Directory หนังสือของเรา แล้วเราจะได้
| | 470 ./test_to_build.pml |
|---|---|
| | 487 ./dbc.pml |
| | 719 ./domain_languages.pml |
| | 727 ./dry.pml |
| | 9561 total |
บรรทัดสุดท้ายนั้นคือจำนวนบรรทัดรวมของไฟล์ทั้งหมด (ไม่ใช่แค่ที่แสดงอยู่) เพราะนั่นคือสิ่งที่ wc ทำครับ เราสามารถตัดมันออกได้โดยการขอบรรทัดเพิ่มอีกหนึ่งบรรทัดจาก tail แล้วก็ไม่สนใจบรรทัดสุดท้ายนั้น:
| | $ find . -type f | xargs wc -l | sort -n | tail -6 | head -5 |
|---|---|
| | 470 ./debug.pml |
| | 470 ./test_to_build.pml |
| | 487 ./dbc.pml |
| | 719 ./domain_languages.pml |
| | 727 ./dry.pml |
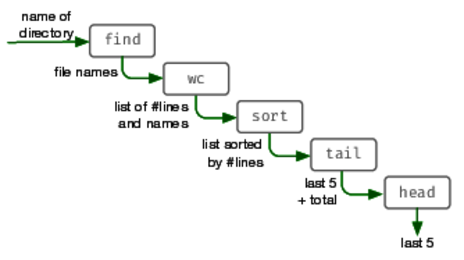
รูปที่ 1 Pipeline ของ find ในรูปแบบชุดของ Transformation
แผนภาพ Pipeline อธิบายชุดของ Transformation โดยแนวทางเป็นแบบบนลงล่าง อันดับแรกคือหาชื่อ Directory ที่จะดึงชื่อไฟล์มา จากนั้นใช้โปรแกรม wc เพื่อเรียงลำดับรายการบรรทัดและชื่อไฟล์ ส่วนของ tail จะมีแค่ 5 บรรทัดสุดท้ายเท่านั้น 5 บรรทัดสุดท้ายบวกกับยอดรวมจะเท่ากับส่วนของ head และจากส่วนของ head จะดึง 5 บรรทัดสุดท้ายออกมา
ลองมาดูกันในมุมมองของข้อมูลที่ไหลผ่านแต่ละ Step กันดีกว่าครับ Requirement เดิมของเราคือ “ไฟล์ 5 อันดับแรกที่มีจำนวนบรรทัดมากที่สุด” จะกลายเป็นชุดของ Transformation (ตามที่แสดงใน รูปภาพ ด้วย)
ชื่อ Directory
→ รายการไฟล์
→ รายการพร้อมหมายเลขบรรทัด
→ รายการที่เรียงลำดับแล้ว
→ 5 อันดับสูงสุด + ยอดรวม
→ 5 อันดับสูงสุด
มันแทบจะเหมือนกับสายการผลิตในโรงงานอุตสาหกรรมเลยครับ ป้อนข้อมูลดิบเข้าไปด้านหนึ่ง แล้วผลิตภัณฑ์สำเร็จรูป (ข้อมูลสารสนเทศ) ก็จะออกมาอีกด้านหนึ่ง
และเราก็ชอบที่จะมอง Code ทั้งหมดในรูปแบบนี้ครับ
| Tip 49 | Programming คือเรื่องของ Code แต่ Program คือเรื่องของ Data |
|---|
Finding Transformations (การค้นหา Transformation)
บางครั้งวิธีที่ง่ายที่สุดในการหา Transformation ก็คือเริ่มจาก Requirement แล้วหา Input กับ Output ของมัน ตอนนี้คุณก็นิยาม Function ที่แทนโปรแกรมโดยรวมได้แล้ว จากนั้นคุณก็หา Step ต่างๆ ที่จะพาคุณจาก Input ไปยัง Output ได้ นี่คือแนวทางแบบ top-down ครับ
ตัวอย่างเช่น คุณต้องการสร้างเว็บไซต์สำหรับคนที่เล่นเกมคำศัพท์ ที่จะหาคำทั้งหมดที่สามารถสร้างได้จากชุดตัวอักษรที่กำหนด Input ของคุณในที่นี้คือชุดตัวอักษร ส่วน Output ก็คือรายการคำ 3 ตัวอักษร, คำ 4 ตัวอักษร และต่อไปเรื่อยๆ:
| "lvyin" | จะถูกแปลงเป็น → | 3 => ivy, lin, nil, yin4 => inly, liny, viny5 => vinyl |
|---|
(ใช่ครับ ทั้งหมดนี้เป็นคำจริงๆ อย่างน้อยก็ตามพจนานุกรมของ macOS)
กลไกเบื้องหลังแอปพลิเคชันนี้ง่ายมากครับ เรามี Dictionary ที่จัดกลุ่มคำต่างๆ ด้วย signature ที่เลือกมาเพื่อให้คำทุกคำที่มีตัวอักษรชุดเดียวกันมี signature เดียวกัน Signature Function ที่ง่ายที่สุดก็คือรายการตัวอักษรของคำที่เรียงลำดับแล้วนั่นเอง จากนั้นเราก็สามารถค้นหา String ที่ป้อนเข้ามาได้ด้วยการสร้าง Signature ของมันขึ้นมา แล้วดูว่ามีคำไหนบ้าง (ถ้ามี) ใน Dictionary ที่มี Signature เดียวกันนี้
ดังนั้น anagram finder จึงแบ่งย่อยออกเป็น 4 Transformation ที่แยกจากกันครับ:
| ขั้นตอน | Transformation | ข้อมูลตัวอย่าง |
|---|---|---|
| ขั้นตอนที่ 0: | Input เริ่มต้น | "ylvin" |
| ขั้นตอนที่ 1: | ชุดผสมทั้งหมดที่มีตัวอักษรตั้งแต่ 3 ตัวขึ้นไป | vin, viy, vil, vny, vnl, vyl, iny, inl, iyl, nyl, viny, vinl, viyl, vnyl, inyl, vinyl |
| ขั้นตอนที่ 2: | Signature ของชุดผสมต่างๆ | inv, ivy, ilv, nvy, lnv, lvy, iny, iln, ily, lny, invy, ilnv, ilvy, lnvy, ilny, ilnvy |
| ขั้นตอนที่ 3: | รายการคำทั้งหมดใน Dictionary ที่ตรงกับ Signature ใดๆ | ivy, yin, nil, lin, viny, liny, inly, vinyl |
| ขั้นตอนที่ 4: | คำที่จัดกลุ่มตามความยาว | 3 => ivy, lin, nil, yin
4 => inly, liny, viny
5 => vinyl |
Transformations All the Way Down (Transformation ลงลึกไปทุกระดับ)
เริ่มต้นด้วยการดู Step 1 กันก่อนครับ ซึ่งจะรับคำหนึ่งคำแล้วสร้างรายการชุดผสมทั้งหมดที่มีตัวอักษรตั้งแต่ 3 ตัวขึ้นไป Step นี้เองก็สามารถแสดงเป็นรายการของ Transformation ได้เช่นกัน:
| ขั้นตอน | Transformation | ข้อมูลตัวอย่าง |
|---|---|---|
| ขั้นตอนที่ 1.0: | Input เริ่มต้น | "vinyl" |
| ขั้นตอนที่ 1.1: | แปลงเป็นตัวอักษรแยกทีละตัว | v, i, n, y, l |
| ขั้นตอนที่ 1.2: | หา Subset ทั้งหมด | [], [v], [i], … [v,i], [v,n], [v,y], … [v,i,n], [v,i,y], … [v,n,y,l], [i,n,y,l], [v,i,n,y,l] |
| ขั้นตอนที่ 1.3: | เฉพาะที่มีความยาวมากกว่า 3 ตัวอักษร | [v,i,n], [v,i,y], … [i,n,y,l], [v,i,n,y,l] |
| ขั้นตอนที่ 1.4: | แปลงกลับเป็น String | [vin,viy, … inyl,vinyl] |
ตอนนี้เรามาถึงจุดที่สามารถ Implement แต่ละ Transformation เป็น Code ได้อย่างง่ายดายแล้วครับ (ในที่นี้ใช้ภาษา Elixir):
function-pipelines/anagrams/lib/anagrams.ex
| | defp all_subsets_longer_than_three_characters(word) do |
|---|---|
| | word |
| | |> String.codepoints() |
| | |> Comb.subsets() |
| | |> Stream.filter( fn subset -> length(subset) >= 3 end ) |
| | |> Stream.map(&List.to_string(&1)) |
| | end |
What's with the |> Operator? (Operator |> คืออะไร)
Elixir พร้อมกับภาษา Functional อื่นๆ อีกหลายภาษา มี Pipeline Operator ที่บางครั้งก็เรียกว่า forward pipe หรือเรียกสั้นๆ ว่า pipe . [41] สิ่งที่มันทำก็คือรับค่าทางด้านซ้ายแล้วใส่มันเป็น Parameter ตัวแรกของ Function ทางด้านขวา ดังนั้น
| | " vinyl" |> String.codepoints |> Comb.subsets() |
|---|
ก็เหมือนกับการเขียนว่า
| | Comb.subsets(String.codepoints( " vinyl" )) |
|---|
(ภาษาอื่นๆ อาจจะแทรกค่าที่ Pipe มาเป็น Parameter ตัว สุดท้าย ของ Function ถัดไปแทน ซึ่งส่วนใหญ่ก็ขึ้นอยู่กับ Style ของ Library มาตรฐานของแต่ละภาษาครับ)
คุณอาจจะคิดว่านี่เป็นแค่ Syntactic Sugar แต่จริงๆ แล้ว Pipeline Operator คือโอกาสปฏิวัติวิธีคิดของเราเลยครับ การใช้ Pipeline หมายความว่าคุณกำลังคิดในรูปแบบของการแปลงข้อมูลโดยอัตโนมัติ ทุกครั้งที่คุณเห็น |> คุณกำลังเห็นจุดที่ข้อมูลไหลจาก Transformation หนึ่งไปยังอีก Transformation หนึ่งจริงๆ
หลายภาษาก็มีอะไรทำนองนี้เหมือนกันครับ Elm และ F# มี |> , Clojure มี -> และ ->> (ซึ่งทำงานต่างออกไปนิดหน่อย) ส่วน R มี %>% . Haskell เองก็มีทั้ง Pipe Operator และยังทำให้การประกาศ Operator ใหม่ทำได้ง่ายอีกด้วย ตอนที่เรากำลังเขียนหนังสือเล่มนี้อยู่ ก็มีกระแสพูดถึงการเพิ่ม |> เข้าไปใน JavaScript ด้วยครับ
ถ้าภาษาที่คุณใช้อยู่รองรับอะไรทำนองนี้ ก็ถือว่าคุณโชคดีครับ แต่ถ้าไม่รองรับ ลองดูที่ Language X Doesn't Have Pipelines .
เอาล่ะ กลับมาที่ Code กันต่อครับ
Keep on Transforming… (แปลงข้อมูลกันต่อไป…)
ทีนี้มาดู Step 2 ของโปรแกรมหลักกันบ้างครับ ซึ่งเป็นขั้นตอนที่เราแปลง Subset ให้กลายเป็น Signature อีกครั้ง นี่ก็เป็น Transformation ง่ายๆ เช่นกัน คือแปลงรายการ Subset ให้กลายเป็นรายการ Signature:
| ขั้นตอน | Transformation | ข้อมูลตัวอย่าง |
|---|---|---|
| ขั้นตอนที่ 2.0: | Input เริ่มต้น | vin, viy, … inyl, vinyl |
| ขั้นตอนที่ 2.1: | แปลงเป็น signature | inv, ivy … ilny, inlvy |
Code ภาษา Elixir ใน Listing ต่อไปนี้ก็ง่ายพอๆ กันครับ:
function-pipelines/anagrams/lib/anagrams.ex
| | defp as_unique_signatures(subsets) do |
|---|---|
| | subsets |
| | |> Stream.map(&Dictionary.signature_of/1) |
| | end |
ทีนี้เราจะแปลงรายการ Signature นั้นต่อครับ แต่ละ Signature จะถูก Map ไปยังรายการคำที่รู้จักอยู่แล้วซึ่งมี Signature เดียวกัน หรือเป็น nil ถ้าไม่มีคำแบบนั้นอยู่เลย จากนั้นเราก็ต้องเอา nils ออก แล้วทำให้รายการที่ซ้อนกันอยู่แบนราบลงเหลือแค่ระดับเดียว:
function-pipelines/anagrams/lib/anagrams.ex
| | defp find_in_dictionary(signatures) do |
|---|---|
| | signatures |
| | |> Stream.map(&Dictionary.lookup_by_signature/1) |
| | |> Stream.reject(&is_nil/1) |
| | |> Stream.concat(&(&1)) |
| | end |
Step 4 คือการจัดกลุ่มคำตามความยาว ก็เป็นอีกหนึ่ง Transformation ง่ายๆ ที่แปลงรายการของเราให้กลายเป็น Map ที่มี Key เป็นความยาว และ Value เป็นคำทั้งหมดที่มีความยาวนั้นครับ:
function-pipelines/anagrams/lib/anagrams.ex
| | defp group_by_length(words) do |
|---|---|
| | words |
| | |> Enum.sort() |
| | |> Enum.group_by(&String.length/1) |
| | end |
Language X Doesn't Have Pipelines (ถ้าภาษา X ไม่มี Pipeline)
Pipeline มีมานานแล้วครับ แต่อยู่แค่ในกลุ่มภาษาเฉพาะทาง เพิ่งจะเข้ามาเป็นกระแสหลักเมื่อไม่นานมานี้เอง และภาษายอดนิยมหลายภาษาก็ยังไม่รองรับแนวคิดนี้
ข่าวดีก็คือการคิดแบบ Transformation ไม่จำเป็นต้องพึ่งพา Syntax เฉพาะของภาษาใดภาษาหนึ่งครับ มันเป็นปรัชญาการ Design มากกว่า คุณยังคงสร้าง Code ของคุณในรูปแบบ Transformation ได้เหมือนเดิม แต่เขียนมันออกมาเป็นชุดของการ Assign ค่าแทน:
| | const content = File.read(file_name); |
|---|---|
| | const lines = find_matching_lines(content, pattern) |
| | const result = truncate_lines(lines) |
มันอาจจะดูยุ่งยากกว่านิดหน่อย แต่ก็ทำงานได้ตามที่ต้องการครับ
Putting It All Together (นำทุกอย่างมารวมกัน)
เราเขียนแต่ละ Transformation แยกกันเสร็จแล้ว ตอนนี้ก็ถึงเวลาร้อยเรียงพวกมันเข้าด้วยกันเป็น Function หลักของเราแล้วครับ:
function-pipelines/anagrams/lib/anagrams.ex
| | def anagrams_in(word) do |
|---|---|
| | word |
| | |> all_subsets_longer_than_three_characters() |
| | |> as_unique_signatures() |
| | |> find_in_dictionary() |
| | |> group_by_length() |
| | end |
มันทำงานได้ไหมนะ? ลองดูกันเลยครับ:
| | iex(1)> Anagrams.anagrams_in " lyvin" |
|---|---|
| | %{ |
| | 3 => ["ivy", "lin", "nil", "yin"], |
| | 4 => ["inly", "liny", "viny"], |
| | 5 => ["vinyl"] |
| | } |
Why Is This So Great? (ทำไมมันถึงเจ๋งขนาดนี้)
ลองมาดู Body ของ Function หลักกันอีกครั้งครับ:
| | word |
|---|---|
| | |> all_subsets_longer_than_three_characters() |
| | |> as_unique_signatures() |
| | |> find_in_dictionary() |
| | |> group_by_length() |
มันคือแค่ Chain ของ Transformation ที่จำเป็นเพื่อตอบโจทย์ Requirement ของเรา แต่ละอันรับ Input จาก Transformation ก่อนหน้า แล้วส่ง Output ต่อไปยังอันถัดไป นี่ใกล้เคียงกับสิ่งที่เรียกว่า Literate Code มากที่สุดเท่าที่จะเป็นไปได้แล้วครับ
แต่ก็ยังมีอะไรที่ลึกซึ้งกว่านั้นอีกครับ ถ้าพื้นฐานของคุณมาจาก Object-Oriented Programming สัญชาตญาณของคุณจะบอกให้ซ่อนข้อมูลเอาไว้ โดยห่อหุ้ม (Encapsulate) มันไว้ในตัว Object เหล่านี้ก็จะพูดคุยโต้ตอบกันไปมา คอยเปลี่ยน State ของกันและกัน สิ่งนี้ทำให้เกิด Coupling เยอะมาก และก็เป็นเหตุผลใหญ่ที่ทำให้ระบบแบบ OO เปลี่ยนแปลงได้ยากครับ
| Tip 50 | อย่ากักตุน State ไว้กับตัว จงส่งต่อมันไปเรื่อยๆ |
|---|
ใน Transformational Model เรากลับหัวกลับหางแนวคิดนี้เลยครับ แทนที่จะมี Data กระจัดกระจายเป็นแอ่งเล็กๆ อยู่ทั่วทั้งระบบ ลองมองว่า Data เป็นเหมือนแม่น้ำสายใหญ่ เป็น flow Data จะกลายเป็นสิ่งที่เทียบเท่ากับ Functionality เลยครับ Pipeline ก็คือลำดับของ code → data → code → data…. ข้อมูลจะไม่ถูกผูกติดอยู่กับกลุ่ม Function ใดกลุ่มหนึ่งโดยเฉพาะเหมือนใน Class Definition อีกต่อไป แต่มันมีอิสระที่จะแสดงถึงความคืบหน้าของ Application ของเราขณะที่มันแปลง Input ไปเป็น Output ซึ่งหมายความว่าเราสามารถลด Coupling ลงได้มากเลยครับ Function หนึ่งสามารถถูกใช้ (และใช้ซ้ำ) ได้ทุกที่ที่ Parameter ของมันตรงกับ Output ของ Function อื่น
ใช่ครับ ยังคงมี Coupling อยู่บ้าง แต่จากประสบการณ์ของเรา มันจัดการได้ง่ายกว่า Style แบบ Command and Control ของ OO มาก และถ้าคุณใช้ภาษาที่มี Type Checking คุณจะได้รับ Warning ตอน Compile เมื่อคุณพยายามเชื่อมสองสิ่งที่เข้ากันไม่ได้
What About Error Handling? (แล้วเรื่อง Error Handling ล่ะ)
จนถึงตอนนี้ Transformation ของเราทำงานอยู่ในโลกที่ไม่มีอะไรผิดพลาดเลยครับ แต่เราจะเอามันไปใช้ในโลกความเป็นจริงได้ยังไง? ถ้าเราสร้างได้แค่ Chain แบบเส้นตรง แล้วเราจะเพิ่ม Conditional Logic ที่จำเป็นสำหรับการตรวจสอบ Error เข้าไปได้ยังไง?
มีหลายวิธีในการทำแบบนี้ครับ แต่ทั้งหมดอาศัย Convention พื้นฐานเดียวกันคือ เราจะไม่ส่งค่าดิบๆ ระหว่าง Transformation เลย แต่จะห่อมันไว้ใน Data Structure (หรือ Type) ที่บอกเราด้วยว่าค่าที่อยู่ข้างในนั้นถูกต้องหรือไม่ ตัวอย่างเช่นใน Haskell wrapper นี้เรียกว่า Maybe ส่วนใน F# และ Scala เรียกว่า Option .
วิธีการใช้แนวคิดนี้ก็จะแตกต่างกันไปตามแต่ละภาษาครับ แต่โดยทั่วไปแล้ว มีวิธีเขียน Code พื้นฐานอยู่สองแบบ คือคุณจะตรวจสอบ Error ข้างในตัว Transformation เอง หรือตรวจสอบจากข้างนอกก็ได้
Elixir ที่เราใช้กันมาตลอดนั้นไม่มี Support ตัวนี้มาให้ในตัวครับ แต่สำหรับจุดประสงค์ของเรา นี่กลับเป็นเรื่องดี เพราะเราจะได้แสดงวิธี Implement ตั้งแต่ต้นจนจบให้ดู แนวทางคล้ายๆ กันนี้ก็น่าจะใช้ได้กับภาษาอื่นๆ ส่วนใหญ่เช่นกัน
First, Choose a Representation (ขั้นแรก เลือก Representation)
เราต้องการ Representation สำหรับ Wrapper ของเรา (Data Structure ที่พกพาค่าหรือการแจ้งเตือน Error ไปด้วย) คุณสามารถใช้ Structure สำหรับเรื่องนี้ได้ครับ แต่ Elixir มี Convention ที่ค่อนข้างแข็งแรงอยู่แล้วคือ Function มักจะ Return Tuple ที่เป็นได้ทั้ง {:ok, value} หรือ {:error, reason} . ตัวอย่างเช่น File.open จะ Return ได้ทั้ง :ok พร้อม IO Process หรือ :error พร้อม Reason Code:
| | iex(1)> File.open( " /etc/passwd" ) |
|---|---|
| | |
| | iex(2)> File.open( " /etc/wombat" ) |
| |
เราจะใช้ Tuple :ok / :error เป็น Wrapper ของเราเวลาส่งข้อมูลผ่าน Pipeline ครับ
Then Handle It Inside Each Transformation (แล้วจัดการมันในแต่ละ Transformation)
ลองเขียน Function ที่ Return บรรทัดทั้งหมดในไฟล์ที่มี String ที่กำหนด โดยตัดให้เหลือแค่ 20 ตัวอักษรแรกกันดูครับ เราอยากเขียนมันในรูปแบบ Transformation ดังนั้น Input จะเป็นชื่อไฟล์กับ String ที่จะค้นหา ส่วน Output จะเป็นได้ทั้ง Tuple :ok พร้อมรายการบรรทัด หรือ Tuple :error พร้อม Reason บางอย่าง Function ระดับบนสุดควรจะมีหน้าตาประมาณนี้ครับ:
function-pipelines/anagrams/lib/grep.ex
| | def find_all(file_name, pattern) do |
|---|---|
| | File.read(file_name) |
| | |> find_matching_lines(pattern) |
| | |> truncate_lines() |
| | end |
ตรงนี้ไม่มีการตรวจสอบ Error แบบชัดเจนเลยครับ แต่ถ้า Step ไหนใน Pipeline Return Error Tuple ออกมา Pipeline ก็จะ Return Error นั้นกลับไปโดยไม่รัน Function ที่ตามมาต่อเลย [42] เราทำแบบนี้ได้ด้วยการใช้ Pattern Matching ของ Elixir:
function-pipelines/anagrams/lib/grep.ex
| | defp find_matching_lines({ :ok , content}, pattern) do |
|---|---|
| | content |
| | |> String.split( ~r/\n/ ) |
| | |> Enum.filter(&String.match?(&1, pattern)) |
| | |> ok_unless_empty() |
| | end |
| | |
| | defp findmatching_lines(error, ), do : error |
| | |
| | # ---------- |
| | |
| | defp truncate_lines({ :ok , lines }) do |
| | lines |
| | |> Enum.map(&String.slice(&1, 0, 20)) |
| | |> ok() |
| | end |
| | |
| | defp truncate_lines(error), do : error |
| | |
| | # ---------- |
| | |
| | defp ok_unless_empty([]), do : error( " nothing found" ) |
| | defp ok_unless_empty(result), do : ok(result) |
| | |
| | defp ok(result), do : { :ok , result } |
| | defp error(reason), do : { :error , reason } |
ลองดู Function find_matching_lines กันครับ ถ้า Parameter ตัวแรกของมันเป็น Tuple :ok มันก็จะใช้ Content ใน Tuple นั้นไปหาบรรทัดที่ตรงกับ Pattern แต่ถ้า Parameter ตัวแรก ไม่ใช่ Tuple :ok Function เวอร์ชันที่สองก็จะทำงานแทน ซึ่งก็แค่ Return Parameter นั้นกลับไปเฉยๆ วิธีนี้ทำให้ Function ส่งต่อ Error ลงไปใน Pipeline ได้อย่างง่ายๆ และก็ใช้หลักการเดียวกันนี้กับ truncate_lines ด้วยครับ
ลองมาเล่นกับมันใน Console กันดูครับ:
| | iex> Grep.find_all " /etc/passwd" , ~r/www/ |
|---|---|
| |
| | iex> Grep.find_all " /etc/passwd" , ~r/wombat/ |
|---|---|
| | |
| | iex> Grep.find_all " /etc/koala" , ~r/www/ |
| |
จะเห็นได้ว่า Error ที่เกิดขึ้นตรงไหนก็ได้ใน Pipeline จะกลายเป็นค่าของ Pipeline นั้นทันทีครับ
Or Handle It in the Pipeline (หรือจะจัดการมันใน Pipeline เลยก็ได้)
คุณอาจจะมองที่ Function find_matching_lines และ truncate_lines แล้วคิดว่าเราแค่ย้ายภาระของการจัดการ Error ไปไว้ใน Transformation แทน ซึ่งคุณคิดถูกครับ ในภาษาที่ใช้ Pattern Matching กับการเรียก Function อย่าง Elixir ผลกระทบตรงนี้จะน้อยลง แต่ก็ยังดูไม่สวยงามอยู่ดี
ถ้า Elixir มี Pipeline Operator |> อีกเวอร์ชันหนึ่งที่รู้จัก Tuple :ok / :error และหยุดการทำงานทันที (Short-circuit) เมื่อเกิด Error ก็คงจะดีครับ [43] แต่การที่มันไม่มีแบบนั้น ก็ทำให้เราสามารถเพิ่มอะไรที่คล้ายๆ กันเข้าไปเองได้ และในแบบที่นำไปใช้ได้กับภาษาอื่นๆ อีกหลายภาษาด้วย
ปัญหาที่เราเจอก็คือ เมื่อเกิด Error ขึ้น เราไม่อยากให้ Code ที่อยู่ถัดลงไปใน Pipeline ทำงานต่อ และก็ไม่อยากให้ Code นั้นรู้ด้วยว่ามีเหตุการณ์นี้เกิดขึ้น นั่นหมายความว่าเราต้องเลื่อนการรัน Function ใน Pipeline ออกไปก่อน จนกว่าเราจะรู้ว่า Step ก่อนหน้าใน Pipeline สำเร็จแล้ว ในการทำแบบนี้ เราต้องเปลี่ยนมันจากการ เรียก (calls) Function ให้กลายเป็น ค่า (values) ของ Function ที่จะถูกเรียกใช้ทีหลังแทน นี่คือ Implementation หนึ่งครับ:
function-pipelines/anagrams/lib/grep1.ex
| | defmodule Grep1 do |
|---|---|
| | |
| | def and_then({ :ok , value }, func), do : func.(value) |
| | def and_then(anything_else, _func), do : anything_else |
| | |
| | def find_all(file_name, pattern) do |
| | File.read(file_name) |
| | |> and_then(&find_matching_lines(&1, pattern)) |
| | |> and_then(&truncate_lines(&1)) |
| | end |
| | |
| | defp find_matching_lines(content, pattern) do |
| | content |
| | |> String.split( ~r/\n/ ) |
| | |> Enum.filter(&String.match?(&1, pattern)) |
| | |> ok_unless_empty() |
| | end |
| | |
| | defp truncate_lines(lines) do |
| | lines |
| | |> Enum.map(&String.slice(&1, 0, 20)) |
| | |> ok() |
| | end |
| | |
| | |
| | defp ok_unless_empty([]), do : error( " nothing found" ) |
| | defp ok_unless_empty(result), do : ok(result) |
| | |
| | defp ok(result), do : { :ok , result } |
| | defp error(reason), do : { :error , reason } |
| | end |
Function and_then เป็นตัวอย่างของ Function แบบ bind ครับ มันรับค่าที่ถูกห่ออยู่ในอะไรบางอย่าง แล้วนำ Function มาใช้กับค่านั้น แล้ว Return ค่าที่ถูกห่อใหม่ออกมา การใช้ Function and_then ใน Pipeline ต้องเพิ่มเครื่องหมายวรรคตอนนิดหน่อย เพราะ Elixir ต้องถูกบอกให้แปลงการเรียก Function ให้กลายเป็นค่าของ Function แต่ความพยายามที่เพิ่มขึ้นนี้ก็คุ้มค่า เพราะ Transformation ต่างๆ จะกลายเป็นเรื่องง่ายขึ้นมาก แต่ละตัวแค่รับค่า (และ Parameter เพิ่มเติมถ้ามี) แล้ว Return {:ok, new_value} หรือ {:error, reason}
Transformations Transform Programming (Transformation เปลี่ยนวิธีการเขียนโปรแกรม)
การมอง Code เป็นชุดของ Transformation ที่ซ้อนกันอยู่ (Nested) สามารถเป็นแนวทางที่ปลดปล่อยการเขียนโปรแกรมได้เลยครับ มันต้องใช้เวลาสักพักกว่าจะคุ้นเคย แต่พอคุณสร้างนิสัยนี้ได้แล้ว คุณจะพบว่า Code ของคุณสะอาดขึ้น Function สั้นลง และ Design ของคุณก็แบนราบขึ้น
ลองดูสักตั้งครับ
Related Sections Include (หัวข้อที่เกี่ยวข้อง)
- หัวข้อที่ 8, The Essence of Good Design
- หัวข้อที่ 17, Shell Games
- หัวข้อที่ 26, How to Balance Resources
- หัวข้อที่ 28, Decoupling
- หัวข้อที่ 35, Actors and Processes
Exercises (แบบฝึกหัด)
แบบฝึกหัดที่ 21 ( คำตอบที่เป็นไปได้ )
คุณสามารถแสดง Requirement ต่อไปนี้ในรูปแบบ Transformation ระดับบนสุดได้ไหม? นั่นคือ สำหรับแต่ละข้อ ให้ระบุ Input และ Output ของมัน
- ค่าจัดส่งและภาษีขายถูกเพิ่มเข้าไปใน Order
- Application ของคุณโหลดข้อมูล Configuration จากไฟล์ที่ระบุชื่อไว้
- มีคนล็อกอินเข้าสู่ Web Application
แบบฝึกหัดที่ 22 ( คำตอบที่เป็นไปได้ )
คุณพบว่าจำเป็นต้อง Validate และแปลงฟิลด์ Input จาก String ให้กลายเป็นจำนวนเต็มที่อยู่ระหว่าง 18 ถึง 150 Transformation โดยรวมอธิบายได้ดังนี้
| | เนื้อหาของฟิลด์ในรูปแบบ string |
|---|---|
| | → [validate & convert] |
| | → {:ok, value} | {:error, reason} |
เขียน Transformation แต่ละตัวที่ประกอบกันเป็น validate & convert .
แบบฝึกหัดที่ 23 ( คำตอบที่เป็นไปได้ )
ใน Language X Doesn't Have Pipelines เราเขียนไว้ว่า:
| | const content = File.read(file_name); |
|---|---|
| | const lines = find_matching_lines(content, pattern) |
| | const result = truncate_lines(lines) |
หลายคนเขียน Code แบบ OO ด้วยการ Chain การเรียก Method เข้าด้วยกัน และอาจจะอยากเขียนมันออกมาประมาณนี้:
| | const result = content_of(file_name) |
|---|---|
| | .find_matching_lines(pattern) |
| | .truncate_lines() |
Code สองแบบนี้ต่างกันยังไง? แล้วคุณคิดว่าเราชอบแบบไหนมากกว่ากัน?