16
ENABLE FEEDBACK SO DEVELOPMENT AND OPERATIONS CAN SAFELY DEPLOY CODE (สร้าง Feedback เพื่อให้ Dev และ Ops สามารถ Deploy โค้ดได้อย่างปลอดภัย)
I n 2006 นั้น Nick Galbreath ดำรงตำแหน่ง VP of Engineering ที่ Right Media และรับผิดชอบทั้งฝ่าย Development และ Operations สำหรับแพลตฟอร์มโฆษณาออนไลน์ที่แสดงและให้บริการมากกว่าสิบพันล้านครั้งต่อวัน 1
Galbreath อธิบายถึงสภาพแวดล้อมการแข่งขันที่พวกเขาดำเนินงานไว้ดังนี้:
ในธุรกิจของเรา ระดับสินค้าคงคลังโฆษณามีความผันผวนอย่างมาก เราจึงต้องตอบสนองต่อสภาวะตลาดภายในไม่กี่นาที นั่นหมายความว่า Development ต้องสามารถเปลี่ยนแปลงโค้ดได้อย่างรวดเร็วและนำขึ้น Production โดยเร็วที่สุด มิฉะนั้นเราจะเสียเปรียบคู่แข่งที่เร็วกว่า เราพบว่าการมีทีมทดสอบและแม้แต่ทีม Deploy แยกต่างหากนั้นช้าเกินไป เราต้องรวมฟังก์ชันทั้งหมดนี้ไว้ในทีมเดียว โดยมีความรับผิดชอบและเป้าหมายร่วมกัน เชื่อหรือไม่ว่าความท้าทายที่ใหญ่ที่สุดของเราคือการทำให้นักพัฒนากล้าเอาชนะความกลัวในการ Deploy โค้ดของตัวเอง! 2
มีข้อขัดแย้งที่น่าสนใจอยู่ตรงนี้: โดยปกติ Dev มักจะบ่นว่า Ops กลัวการ Deploy โค้ด แต่ในกรณีนี้ เมื่อได้รับอำนาจในการ Deploy โค้ดของตัวเอง นักพัฒนากลับกลัวการทำ Deploy ไม่แพ้กัน
ความกลัวในการ Deploy โค้ดที่ทั้ง Dev และ Ops ที่ Right Media มีร่วมกันนั้นไม่ใช่เรื่องแปลก อย่างไรก็ตาม Galbreath สังเกตว่าการให้ Feedback ที่เร็วและถี่ขึ้นแก่วิศวกรที่ทำการ Deploy (ไม่ว่าจะเป็น Dev หรือ Ops) รวมถึงการลด Batch Size ของงานของพวกเขา ทำให้เกิดความปลอดภัยและตามมาด้วยความมั่นใจ 3
หลังจากสังเกตทีมจำนวนมากที่ผ่านการเปลี่ยนแปลงนี้ Galbreath อธิบายถึงพัฒนาการของพวกเขาไว้ดังนี้:
เราเริ่มต้นจากสถานะที่ไม่มีใครใน Dev หรือ Ops กล้ากดปุ่ม "Deploy โค้ด" ที่เราสร้างขึ้นมาเพื่อทำระบบ Automate กระบวนการ Deploy ทั้งหมด เพราะกลัวว่าจะเป็นคนแรกที่อาจทำให้ระบบ Production ทั้งระบบล่ม จนกระทั่งมีคนกล้าพอที่จะอาสา Push โค้ดของตัวเองขึ้น Production ซึ่งแน่นอนว่าด้วยสมมติฐานที่ไม่ถูกต้องหรือรายละเอียดปลีกย่อยของ Production ที่เรายังเข้าใจไม่ถ่องแท้ การ Deploy ครั้งแรกย่อมไม่ราบรื่น และเนื่องจากเรายังไม่มี Production Telemetry ที่เพียงพอ เราจึงรู้ว่ามีปัญหาก็ต่อเมื่อลูกค้ามาแจ้งเรา 4
เพื่อแก้ปัญหา ทีมควรรีบแก้ไขโค้ดและ Push ขึ้น Production ทันที แต่คราวนี้ต้องเพิ่ม Production Telemetry ใน Application และ Environment ให้มากขึ้น วิธีนี้จะช่วยให้เรายืนยันได้ว่าการแก้ไขของเราฟื้นฟูบริการได้ถูกต้อง และครั้งหน้าเราจะสามารถตรวจพบปัญหาประเภทนี้ได้ก่อนที่ลูกค้าจะมาแจ้ง
ต่อมา นักพัฒนาจำนวนมากขึ้นเริ่ม Push โค้ดของตัวเองขึ้น Production และเนื่องจากเรากำลังทำงานในระบบที่ซับซ้อน เราก็อาจจะยังทำอะไรพังใน Production ได้ แต่ครั้งนี้เราจะสามารถเห็นได้อย่างรวดเร็วว่าฟังก์ชันอะไรเสีย และตัดสินใจได้เร็วว่าจะ Roll Back หรือ Fix Forward เพื่อแก้ปัญหา นี่คือชัยชนะครั้งใหญ่ของทั้งทีม และทุกคนก็ร่วมฉลอง — จากนี้ไปเราก็เริ่มไปได้สวย
อย่างไรก็ตาม ทีมต้องการปรับปรุงผลลัพธ์ของการ Deploy ให้ดีขึ้น นักพัฒนาจึงเริ่มขอ Peer Review การเปลี่ยนแปลงโค้ดของตัวเองมากขึ้น (อธิบายไว้ใน Chapter 18 ) และทุกคนก็ช่วยกันเขียน Automated Tests ที่ดีขึ้นเพื่อค้นหาข้อผิดพลาดก่อนการ Deploy และเพราะทุกคนรู้แล้วว่ายิ่งการเปลี่ยนแปลงใน Production มีขนาดเล็กเท่าไหร่ ปัญหาก็จะยิ่งน้อยลงเท่านั้น นักพัฒนาจึงเริ่มตรวจสอบโค้ดในปริมาณที่เล็กลงเรื่อย ๆ แต่ถี่ขึ้นใน Deployment Pipeline เพื่อให้แน่ใจว่าการเปลี่ยนแปลงของพวกเขาทำงานได้สำเร็จใน Production ก่อนที่จะไปทำการเปลี่ยนแปลงถัดไป
ตอนนี้เรากำลัง Deploy โค้ดถี่กว่าที่เคยเป็นมา และความเสถียรของบริการก็ดีขึ้นกว่าเดิมเช่นกัน เราค้นพบอีกครั้งว่าความลับของ Flow ที่ราบรื่นและต่อเนื่องคือการเปลี่ยนแปลงเล็ก ๆ ที่เกิดขึ้นบ่อยครั้ง ซึ่งทุกคนสามารถตรวจสอบและทำความเข้าใจได้ง่าย
Galbreath สังเกตว่าพัฒนาการข้างต้นเป็นประโยชน์ต่อทุกคน รวมถึง Development, Operations และ Infosec
ในฐานะคนที่รับผิดชอบด้านความปลอดภัยด้วย เป็นเรื่องที่ reassuring ที่รู้ว่าเราสามารถ Deploy ฟิกซ์ขึ้น Production ได้อย่างรวดเร็ว เพราะการเปลี่ยนแปลงต่าง ๆ ถูก Push ขึ้น Production ตลอดทั้งวัน ยิ่งไปกว่านั้น มันทำให้ผมประหลาดใจเสมอที่วิศวกรทุกคนสนใจเรื่องความปลอดภัยมากขึ้นเมื่อคุณพบปัญหาในโค้ดที่พวกเขารับผิดชอบ และพวกเขาสามารถแก้ไขมันได้ด้วยตัวเองอย่างรวดเร็ว 5
เรื่องราวของ Right Media แสดงให้เห็นว่าการ Automate กระบวนการ Deploy เพียงอย่างเดียวนั้นไม่พอ — เรายังต้องบูรณาการการตรวจสอบ Production Telemetry เข้ากับงาน Deploy ของเรา รวมถึงสร้างบรรทัดฐานทางวัฒนธรรมที่ว่าทุกคนมีความรับผิดชอบเท่าเทียมกันต่อสุขภาพของ Value Stream ทั้งหมด
ในบทนี้ เราจะสร้างกลไก Feedback ที่ช่วยให้เราปรับปรุงสุขภาพของ Value Stream ในทุกขั้นตอนของวงจรชีวิตบริการ ตั้งแต่การออกแบบผลิตภัณฑ์ ไปจนถึงการพัฒนาและ Deploy และการดำเนินงาน จนกระทั่งเลิกใช้งาน การทำเช่นนี้จะช่วยให้เรามั่นใจได้ว่าบริการของเราพร้อมสำหรับ Production ("production ready") ตั้งแต่ช่วงแรก ๆ ของโครงการ รวมถึงนำบทเรียนจากแต่ละ Release และปัญหาใน Production มาใช้ในงานในอนาคต ซึ่งส่งผลให้เกิดความปลอดภัยและประสิทธิผลที่ดีขึ้นสำหรับทุกคน
Use Telemetry to Make Deployments Safer (ใช้ Telemetry เพื่อทำให้การ Deploy ปลอดภัยยิ่งขึ้น)
ในขั้นตอนนี้ เราจะต้องมั่นใจว่าเรากำลังตรวจสอบ Production Telemetry อย่างจริงจังเมื่อมีคนทำการ Deploy ขึ้น Production ดังที่แสดงในเรื่องราวของ Right Media วิธีนี้ช่วยให้คนที่ทำ Deploy ไม่ว่าจะเป็น Dev หรือ Ops สามารถตรวจสอบได้อย่างรวดเร็วว่าฟีเจอร์ต่าง ๆ ทำงานตามที่ออกแบบไว้หรือไม่หลังจาก Release ใหม่ขึ้น Production ท้ายที่สุดแล้ว เราไม่ควรถือว่าการ Deploy โค้ดหรือการเปลี่ยนแปลง Production เสร็จสมบูรณ์จนกว่ามันจะทำงานได้ตามที่ออกแบบไว้ในสภาพแวดล้อม Production จริง
เราทำสิ่งนี้โดยการตรวจสอบ Metrics ที่เกี่ยวข้องกับฟีเจอร์ของเราอย่างจริงจังระหว่างการ Deploy เพื่อให้แน่ใจว่าเราไม่ได้ทำให้บริการของเราเสียหายโดยไม่ได้ตั้งใจ — หรือแย่กว่านั้นคือทำให้บริการอื่นเสียหาย หากการเปลี่ยนแปลงของเราทำให้ฟังก์ชันใดเสียหรือทำงานด้อยลง เราจะรีบทำงานเพื่อฟื้นฟูบริการ โดยเรียกคนอื่น ๆ ที่จำเป็นเข้ามาช่วยวินิจฉัยและแก้ไขปัญหา *
ตามที่อธิบายไว้ใน Part III เป้าหมายของเราคือการจับข้อผิดพลาดใน Deployment Pipeline ก่อนที่มันจะถึง Production อย่างไรก็ตาม จะยังมีข้อผิดพลาดที่เราไม่สามารถตรวจพบได้ และเราจะพึ่งพา Production Telemetry เพื่อฟื้นฟูบริการอย่างรวดเร็ว เราอาจเลือกปิดฟีเจอร์ที่เสียด้วย Feature Toggles (ซึ่งมักเป็นตัวเลือกที่ง่ายและมีความเสี่ยงน้อยที่สุดเพราะไม่ต้อง Deploy ขึ้น Production) หรือ Fix Forward (คือการเปลี่ยนแปลงโค้ดเพื่อแก้ไขข้อบกพร่อง แล้ว Push ขึ้น Production ผ่าน Deployment Pipeline) หรือ Roll Back (เช่น สลับกลับไปใช้ Release ก่อนหน้าโดยใช้ Feature Toggles หรือนำเซิร์ฟเวอร์ที่เสียออกจาก Rotation โดยใช้ Blue-Green หรือ Canary Release Patterns เป็นต้น)
แม้ว่า Fix Forward มักจะมีความเสี่ยง แต่ก็สามารถปลอดภัยอย่างยิ่งเมื่อเรามี Automated Testing, กระบวนการ Deploy ที่รวดเร็ว และ Telemetry ที่เพียงพอซึ่งช่วยให้เรายืนยันได้อย่างรวดเร็วว่าทุกอย่างทำงานได้ถูกต้องใน Production
Figure 16.1 แสดงการ Deploy การเปลี่ยนแปลงโค้ด PHP ที่ Etsy ซึ่งทำให้เกิด Spike ของ PHP Runtime Warnings — ในกรณีนี้ นักพัฒนาสังเกตเห็นปัญหาได้อย่างรวดเร็วภายในไม่กี่นาที และสร้างฟิกซ์แล้ว Deploy ขึ้น Production แก้ไขปัญหาได้ในเวลาไม่ถึงสิบนาที
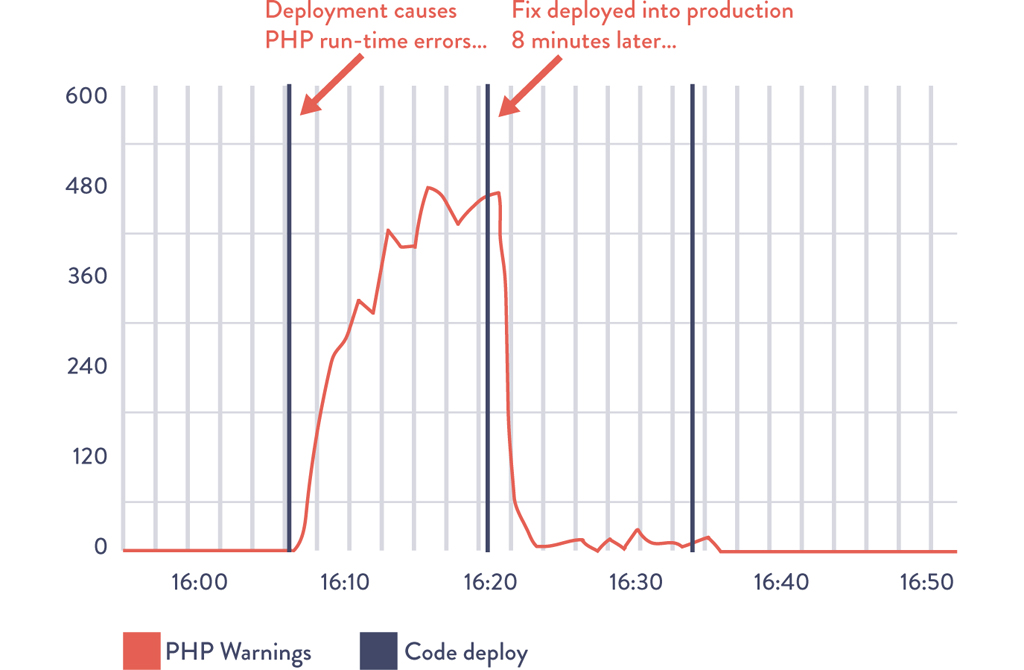
Figure 16.1: การ Deploy ไปยัง Etsy.com ทำให้เกิด PHP Runtime Warnings และถูกแก้ไขอย่างรวดเร็ว
ที่มา: Mike Brittain, "Tracking Every Release."
เนื่องจากการ Deploy Production เป็นหนึ่งในสาเหตุหลักของปัญหา Production การ Deploy และเหตุการณ์การเปลี่ยนแปลงแต่ละครั้งจะถูกซ้อนทับลงบนกราฟ Metrics ของเรา เพื่อให้มั่นใจว่าทุกคนใน Value Stream รับรู้ถึงกิจกรรมที่เกี่ยวข้อง ทำให้เกิดการสื่อสารและการประสานงานที่ดีขึ้น รวมถึงการตรวจจับและการกู้คืนที่เร็วขึ้น
Dev Shares Pager Rotation Duties with Ops (Dev ร่วมเวร Pager กับ Ops)
แม้ว่าการ Deploy และ Release Production ของเราจะดำเนินไปอย่างราบรื่น ในบริการที่ซับซ้อนใด ๆ เราก็ยังมีปัญหาที่ไม่คาดคิด เช่น Incident และ Outage ที่เกิดขึ้นในเวลาที่ไม่เหมาะสม (ทุก ๆ ตีสอง) หากปล่อยไว้ไม่แก้ไข ปัญหาเหล่านี้จะกลายเป็นปัญหาซ้ำซากที่สร้างความทุกข์ให้กับวิศวกร Ops ที่อยู่ปลายน้ำ โดยเฉพาะอย่างยิ่งเมื่อปัญหาเหล่านี้ไม่ถูกส่งต่อไปยังวิศวกรต้นน้ำที่รับผิดชอบในการสร้างปัญหา
แม้ว่าปัญหาจะส่งผลให้มีการ Assign Defect ให้ทีม Feature แต่ก็อาจถูกจัดลำดับความสำคัญต่ำกว่าการส่งมอบฟีเจอร์ใหม่ ปัญหาอาจเกิดขึ้นซ้ำแล้วซ้ำอีกเป็นเวลาหลายสัปดาห์ หลายเดือน หรือกระทั่งหลายปี ก่อให้เกิดความโกลาหลและการหยุดชะงักอย่างต่อเนื่องใน Operations นี่คือตัวอย่างว่าศูนย์งานต้นน้ำสามารถปรับให้เหมาะสมเพื่อตัวเอง แต่กลับทำให้ประสิทธิภาพของ Value Stream โดยรวมลดลง
เพื่อป้องกันไม่ให้เกิดเหตุการณ์นี้ เราจะให้ทุกคนใน Value Stream ร่วมแบ่งปันความรับผิดชอบปลายน้ำในการจัดการ Operational Incidents เราสามารถทำได้โดยการให้นักพัฒนา ผู้จัดการฝ่ายพัฒนา และสถาปนิก เข้าร่วมเวร Pager เช่นเดียวกับที่ Pedro Canahuati ผู้อำนวยการฝ่าย Production Engineering ของ Facebook ทำในปี 2009 6 ซึ่งช่วยให้ทุกคนใน Value Stream ได้รับ Feedback โดยตรงต่อการตัดสินใจด้านสถาปัตยกรรมและโค้ดที่พวกเขาทำในระดับต้นน้ำ
การทำเช่นนี้ช่วยให้ Operations ไม่ต้องดิ้นรนอย่างโดดเดี่ยวกับปัญหา Production ที่เกี่ยวกับโค้ดอีกต่อไป แต่ทุกคนจะช่วยกันหาสมดุลที่เหมาะสมระหว่างการแก้ไขข้อบกพร่องใน Production และการพัฒนาฟังก์ชันใหม่ ไม่ว่าพวกเขาจะอยู่ส่วนใดของ Value Stream ก็ตาม ดังที่ Patrick Lightbody, SVP of Product Management ที่ New Relic กล่าวไว้ในปี 2011 ว่า "เราพบว่าเมื่อเราปลุกนักพัฒนาตอนตีสอง ข้อบกพร่องก็ถูกแก้ไขได้เร็วกว่าที่เคย" 7
ผลข้างเคียงอย่างหนึ่งของปฏิบัตินี้คือช่วยให้ผู้บริหารฝ่าย Development เข้าใจว่าเป้าหมายทางธุรกิจไม่ได้บรรลุผลเพียงเพราะฟีเจอร์ถูกทำเครื่องหมายว่า "เสร็จแล้ว" แต่ฟีเจอร์จะเสร็จก็ต่อเมื่อมันทำงานได้ตามที่ออกแบบไว้ใน Production โดยไม่ก่อให้เกิดการ Escalation ที่มากเกินไปหรืองานที่ไม่คาดคิดสำหรับทั้ง Development และ Operations †
ปฏิบัตินี้ใช้ได้ดีทั้งกับทีมที่เน้นตลาดซึ่งรับผิดชอบทั้งการพัฒนาฟีเจอร์และดำเนินงานใน Production และทีมที่เน้นหน้าที่การทำงาน ดังที่ Arup Chakrabarti, Operations Engineering Manager ที่ PagerDuty กล่าวไว้ในการนำเสนอเมื่อปี 2014 ว่า "การมีทีม On-Call โดยเฉพาะกำลังกลายเป็นเรื่องที่พบได้น้อยลงเรื่อย ๆ ในบริษัทต่าง ๆ แต่กลับกัน ทุกคนที่เกี่ยวข้องกับโค้ดและ Environment ใน Production จะถูกคาดหวังให้ติดต่อได้ในกรณีที่ระบบหยุดทำงาน" 8
ไม่ว่าเราจะจัดทีมอย่างไร หลักการพื้นฐานยังคงเหมือนเดิม: เมื่อนักพัฒนาได้รับ Feedback ว่า Application ของพวกเขาทำงานอย่างไรใน Production ซึ่งรวมถึงการแก้ไขเมื่อมันเสีย พวกเขาจะใกล้ชิดกับลูกค้ามากขึ้น สิ่งนี้สร้างความรู้สึกเป็นเจ้าของที่ทุกคนใน Value Stream ได้รับประโยชน์
Have Developers Follow Work Downstream (ให้นักพัฒนาติดตามงานไปยังปลายน้ำ)
หนึ่งในเทคนิคที่ทรงพลังที่สุดในการออกแบบ Interaction และ User Experience (UX) คือ Contextual Inquiry ซึ่งเป็นวิธีการที่ทีมผลิตภัณฑ์ดูผู้ใช้ทำงานกับ Application ในสภาพแวดล้อมธรรมชาติของพวกเขา ซึ่งมักจะเป็นการทำงานที่โต๊ะของพวกเขา การทำเช่นนี้มักเผยให้เห็นวิธีที่น่าตกใจที่ผู้ใช้ต้องดิ้นรนกับ Application เช่น ต้องคลิกหลายสิบครั้งเพื่อทำงานง่าย ๆ ในงานประจำวัน ต้องคัดลอกและวางข้อความจากหลายหน้าจอ หรือต้องจดบันทึกลงกระดาษ สิ่งเหล่านี้ล้วนเป็นตัวอย่างของพฤติกรรมชดเชยและวิธีแก้ปัญหาชั่วคราวสำหรับปัญหาการใช้งาน
ปฏิกิริยาที่พบบ่อยที่สุดของนักพัฒนาหลังจากเข้าร่วมการสังเกตผู้ใช้คือความตกใจ มักจะพูดว่า "มันแย่มากที่ได้เห็นว่าเราสร้างความเจ็บปวดให้ลูกค้าของเรามากมายขนาดไหน" การสังเกตผู้ใช้เหล่านี้มักจะส่งผลให้เกิดการเรียนรู้ที่สำคัญและความปรารถนาอย่างแรงกล้าที่จะปรับปรุงสถานการณ์ให้ดีขึ้นสำหรับลูกค้า
เป้าหมายของเราคือการใช้เทคนิคเดียวกันนี้เพื่อสังเกตว่างานของเราส่งผลต่อลูกค้าภายในของเราอย่างไร นักพัฒนาควรติดตามงานของตนไปยังปลายน้ำ เพื่อให้พวกเขาเห็นว่าศูนย์งานปลายน้ำต้องโต้ตอบกับผลิตภัณฑ์ของพวกเขาอย่างไรเพื่อให้มันทำงานใน Production ได้ ‡
นักพัฒนาอยากติดตามงานของตนไปยังปลายน้ำ — การเห็นความยากลำบากของลูกค้าด้วยตนเองช่วยให้พวกเขาตัดสินใจได้ดีขึ้นและมีข้อมูลมากขึ้นในงานประจำวัน การทำเช่นนี้จะสร้าง Feedback ในด้าน Non-functional Aspects ของโค้ดของเรา — องค์ประกอบทั้งหมดที่ไม่เกี่ยวข้องกับฟีเจอร์ที่ลูกค้าเห็น — และระบุวิธีที่เราสามารถปรับปรุง Deployability, Manageability, Operability และอื่น ๆ
การสังเกต UX มักมีผลกระทบอย่างมากต่อผู้สังเกต เมื่ออธิบายถึงการสังเกตผู้ใช้ครั้งแรกของเขา Gene Kim ผู้ก่อตั้งและ CTO ของ Tripwire เป็นเวลาสิบสามปีและผู้ร่วมเขียนหนังสือเล่มนี้ กล่าวว่า:
ช่วงเวลาที่เลวร้ายที่สุดช่วงหนึ่งในอาชีพการงานของผมคือในปี 2006 เมื่อผมใช้เวลาทั้งเช้าดูแลลูกค้าคนหนึ่งใช้ผลิตภัณฑ์ของเรา ผมดูเขาทำ operation ที่เราคาดหวังให้ลูกค้าทำทุกสัปดาห์ และด้วยความตกใจอย่างที่สุด เราค้นพบว่ามันต้องใช้คลิกถึงหกสิบสามครั้ง คนคนนี้พูดขอโทษซ้ำแล้วซ้ำเล่า พูดประมาณว่า "ขอโทษด้วยนะ คงมีวิธีที่ดีกว่านี้"
น่าเสียดายที่ไม่มีวิธีที่ดีกว่าในการทำ operation นั้น ลูกค้าอีกคนอธิบายว่าการตั้งค่าผลิตภัณฑ์ครั้งแรกใช้ 1,300 ขั้นตอน ทันใดนั้นผมก็เข้าใจว่าทำไมงานจัดการผลิตภัณฑ์ของเราถึงถูกมอบหมายให้วิศวกรหน้าใหม่ที่สุดในทีมเสมอ — ไม่มีใครอยากทำงานดูแลผลิตภัณฑ์ของเรา นั่นคือเหตุผลหนึ่งที่ทำให้ผมช่วยสร้างแนวปฏิบัติ UX ขึ้นในบริษัทของผม เพื่อชดใช้ความเจ็บปวดที่เราก่อให้เกิดกับลูกค้าของเรา
การออกแบบ UX ช่วยสร้างคุณภาพตั้งแต่ต้นทาง (Quality at the Source) และส่งผลให้เกิดความเห็นอกเห็นใจต่อเพื่อนร่วมทีมใน Value Stream มากขึ้น ในอุดมคติแล้ว การออกแบบ UX ช่วยเราในการสร้างข้อกำหนดที่ไม่เกี่ยวกับฟังก์ชัน (Non-functional Requirements) ที่เป็นลายลักษณ์อักษรเพื่อเพิ่มเข้าไปใน Backlog งานร่วมของเรา ซึ่งสุดท้ายแล้วจะช่วยให้เราสามารถบูรณาการข้อกำหนดเหล่านี้ในทุกบริการที่เราสร้างขึ้น ซึ่งเป็นส่วนสำคัญของการสร้างวัฒนธรรมการทำงานแบบ DevOps §
Have Developers Initially Self-Manage Their Production Service (ให้นักพัฒนาดูแลบริการ Production ของตนเองในระยะแรก)
แม้ว่านักพัฒนาจะเขียนและรันโค้ดในสภาพแวดล้อมคล้าย Production ในงานประจำวันของพวกเขาแล้ว Operations ก็อาจยังประสบกับ Production Releases ที่หายนะ เนื่องจากนั่นอาจเป็นครั้งแรกที่เราได้เห็นว่าโค้ดของเราทำงานอย่างไรระหว่างการ Release และภายใต้สภาพ Production จริง ผลลัพธ์นี้เกิดขึ้นเพราะการเรียนรู้ด้านปฏิบัติการมักเกิดขึ้นช้าเกินไปในวงจรชีวิตซอฟต์แวร์
หากปล่อยไว้ไม่จัดการ ผลลัพธ์ที่ได้มักจะเป็นซอฟต์แวร์ Production ที่ดูแลจัดการได้ยาก ดังที่วิศวกร Ops นิรนามคนหนึ่งเคยกล่าวไว้:
ในกลุ่มของเรา ผู้ดูแลระบบส่วนใหญ่อยู่ได้ไม่เกินหกเดือน สิ่งต่าง ๆ ใน Production พังอยู่ตลอดเวลา ชั่วโมงทำงานที่บ้าคลั่ง และการ Deploy แอปพลิเคชันก็เจ็บปวดเกินจะบรรยาย—ส่วนที่แย่ที่สุดคือการจับคู่คลัสเตอร์ Application Server ซึ่งกินเวลาถึงหกชั่วโมง ทุกช่วงเวลานั้น เราทุกคนรู้สึกว่านักพัฒนาเกลียดเราเป็นส่วนตัว 10
นี้อาจเป็นผลลัพธ์จากการมีวิศวกร Ops ไม่เพียงพอที่จะสนับสนุนทีมผลิตภัณฑ์ทั้งหมดและบริการที่มีอยู่ใน Production แล้ว ซึ่งสามารถเกิดขึ้นได้ทั้งในทีมที่เน้นหน้าที่และทีมที่เน้นตลาด
มาตรการป้องกันหนึ่งที่อาจทำได้คือการทำตามสิ่งที่ Google ทำ นั่นคือให้ทีม Development ดูแลบริการของตนเองใน Production เพื่อพิสูจน์ว่าบริการมีความเสถียร ก่อนที่จะมีสิทธิ์ให้ทีม SRE (Site Reliability Engineering) เข้ามาจัดการ การให้นักพัฒนารับผิดชอบการ Deploy และสนับสนุน Production จะช่วยเพิ่มโอกาสในการเปลี่ยนผ่านไปยัง Operations ได้อย่างราบรื่น ¶
เพื่อป้องกันความเป็นไปได้ที่บริการที่ดูแลตนเองซึ่งมีปัญหาจะเข้าสู่ Production และสร้างความเสี่ยงต่อองค์กร เราอาจกำหนด Launch Requirements ที่ต้องปฏิบัติตามเพื่อให้บริการสามารถโต้ตอบกับลูกค้าจริงและรับ Traffic Production จริงได้ นอกจากนี้ เพื่อช่วยเหลือทีมผลิตภัณฑ์ วิศวกร Ops ควรทำหน้าที่เป็นที่ปรึกษาเพื่อช่วยให้บริการของพวกเขาพร้อมสำหรับ Production
การสร้าง Launch Guidance ช่วยให้เรามั่นใจว่าทีมผลิตภัณฑ์ทุกทีมได้รับประโยชน์จากประสบการณ์สะสมและร่วมกันของทั้งองค์กร โดยเฉพาะ Operations แนวทางและข้อกำหนดสำหรับการ Launch อาจรวมถึงสิ่งต่อไปนี้: 11
• จำนวนและความรุนแรงของ Defect: แอปพลิเคชันทำงานตามที่ออกแบบไว้หรือไม่?
• ประเภท/ความถี่ของการแจ้งเตือน Pager: แอปพลิเคชันสร้างการแจ้งเตือนใน Production มากเกินไปหรือไม่?
• ความครอบคลุมของการตรวจสอบ: ความครอบคลุมของการ Monitoring เพียงพอที่จะฟื้นฟูบริการเมื่อมีสิ่งผิดปกติเกิดขึ้นหรือไม่?
• สถาปัตยกรรมระบบ: บริการมีการ Loosely Coupled เพียงพอที่จะรองรับอัตราการเปลี่ยนแปลงและการ Deploy ที่สูงใน Production หรือไม่?
• กระบวนการ Deploy: มีกระบวนการที่คาดการณ์ได้ แน่นอน และมี Automation เพียงพอสำหรับการ Deploy โค้ดขึ้น Production หรือไม่?
• สุขอนามัย Production: มีหลักฐานของนิสัย Production ที่ดีเพียงพอหรือไม่ที่จะให้คนอื่นสามารถดูแล Production ได้?
เมื่อมองผิวเผิน ข้อกำหนดเหล่านี้อาจดูคล้ายกับ Production Checklists แบบดั้งเดิมที่เราเคยใช้ในอดีต อย่างไรก็ตาม ความแตกต่างที่สำคัญคือเรากำหนดให้ต้องมีการ Monitoring ที่มีประสิทธิภาพ การ Deploy ที่เชื่อถือได้และแน่นอน และสถาปัตยกรรมที่ออกแบบมาเพื่อรองรับการ Deploy ที่รวดเร็วและบ่อยครั้ง
หากพบข้อบกพร่องใด ๆ ในระหว่างการตรวจสอบ วิศวกร Ops ที่ได้รับมอบหมายควรช่วยทีม Feature แก้ไขปัญหาหรือแม้กระทั่งช่วยออกแบบบริการใหม่หากจำเป็น เพื่อให้สามารถ Deploy และจัดการใน Production ได้อย่างง่ายดาย
ในขั้นตอนนี้ เราอาจต้องการตรวจสอบด้วยว่าบริการนี้อยู่ภายใต้ข้อกำหนดด้านการปฏิบัติตามกฎระเบียบใด ๆ หรือไม่ หรือมีแนวโน้มที่จะเป็นเช่นนั้นในอนาคต:
• บริการสร้างรายได้จำนวนมากหรือไม่? (ตัวอย่างเช่น หากเป็นมากกว่า 5% ของรายได้รวมของบริษัทมหาชนในสหรัฐฯ จะถือเป็น "บัญชีที่มีนัยสำคัญ" และอยู่ในขอบเขตการปฏิบัติตามมาตรา 404 ของพระราชบัญญัติ Sarbanes-Oxley ปี 2002 [SOX])
• บริการมีการใช้งานสูงหรือมีต้นทุนจากการหยุดทำงาน/ความเสียหายสูงหรือไม่? (กล่าวคือ ปัญหาด้านปฏิบัติการเสี่ยงต่อการสร้างความเสี่ยงด้านความพร้อมใช้งานหรือชื่อเสียงหรือไม่?)
• บริการจัดเก็บข้อมูลผู้ถือบัตรชำระเงิน (เช่น หมายเลขบัตรเครดิต) หรือข้อมูลที่ระบุตัวบุคคลได้ (เช่น หมายเลขประกันสังคมหรือเวชระเบียน) หรือไม่? มีปัญหาด้านความปลอดภัยอื่น ๆ ที่อาจสร้างความเสี่ยงด้านกฎระเบียบ ข้อผูกพันตามสัญญา ความเป็นส่วนตัว หรือชื่อเสียงหรือไม่?
• บริการมีข้อกำหนดการปฏิบัติตามกฎระเบียบหรือสัญญาอื่น ๆ ที่เกี่ยวข้องหรือไม่ เช่น กฎระเบียบการส่งออกของสหรัฐฯ, PCI-DSS, HIPAA และอื่น ๆ?
ข้อมูลนี้ช่วยให้เรามั่นใจว่าเราจัดการไม่เพียงแต่ความเสี่ยงทางเทคนิคที่เกี่ยวข้องกับบริการนี้เท่านั้น แต่ยังรวมถึงความเสี่ยงด้านความปลอดภัยและการปฏิบัติตามกฎระเบียบที่อาจเกิดขึ้นได้อย่างมีประสิทธิภาพ นอกจากนี้ยังเป็นข้อมูลนำเข้าที่สำคัญในการออกแบบสภาพแวดล้อมการควบคุม Production
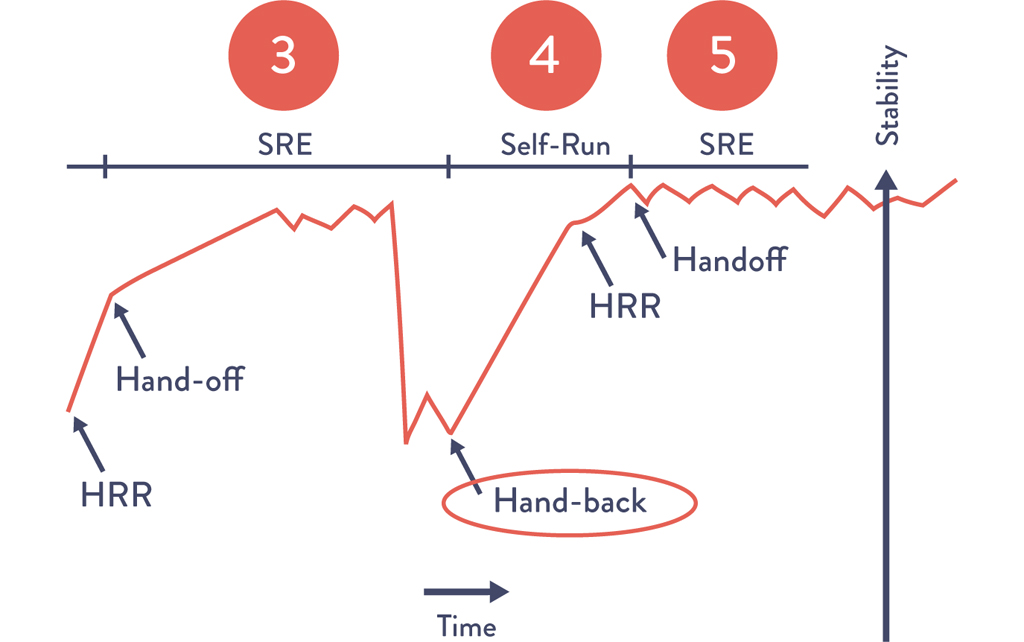
Figure 16.2: "Service Handback" ที่ Google
ที่มา: "SRE@Google: Thousands of DevOps Since 2004," วิดีโอ YouTube, 45:57, โพสต์โดย USENIX, 12 มกราคม 2012, https://www.youtube.com/watch?v=iIuTnhdTzK0 .
การบูรณาการข้อกำหนดด้าน Operability เข้าไปในขั้นตอนแรกสุดของกระบวนการพัฒนา และให้ Development ดูแล Application และบริการของตนเองในระยะแรก ทำให้กระบวนการเปลี่ยนผ่านบริการใหม่เข้าสู่ Production ราบรื่น ง่ายขึ้น และคาดการณ์ได้มากขึ้น อย่างไรก็ตาม สำหรับบริการที่อยู่ใน Production อยู่แล้ว เราจำเป็นต้องมีกลไกที่แตกต่างออกไปเพื่อให้แน่ใจว่า Operations จะไม่ติดอยู่กับบริการที่ไม่สามารถสนับสนุนได้ใน Production ซึ่งมีความเกี่ยวข้องเป็นพิเศษสำหรับองค์กร Operations ที่เน้นหน้าที่การทำงาน
ในขั้นตอนนี้ เราอาจสร้าง กลไก Service Handback — กล่าวคือ เมื่อบริการ Production เปราะบางมากพอ Operations จะมีความสามารถในการส่งคืนความรับผิดชอบในการสนับสนุน Production กลับไปยัง Development
เมื่อบริการกลับไปอยู่ในสถานะที่นักพัฒนาดูแล บทบาทของ Operations จะเปลี่ยนจากการสนับสนุน Production ไปเป็นให้คำปรึกษา ช่วยให้ทีมทำให้บริการพร้อมสำหรับ Production
กลไกนี้ทำหน้าที่เป็นวาล์วระบายแรงดัน ช่วยให้มั่นใจว่าเราจะไม่ทำให้ Operations ต้องตกอยู่ในสถานการณ์ที่ถูกบังคับให้จัดการบริการที่เปราะบาง ในขณะที่หนี้ทางเทคนิคที่เพิ่มขึ้นเรื่อย ๆ ถาโถมทับถมพวกเขา และขยายปัญหาเฉพาะจุดให้กลายเป็นปัญหาระดับองค์กร กลไกนี้ยังช่วยให้แน่ใจว่า Operations มีขีดความสามารถเพียงพอที่จะทำงานปรับปรุงและโครงการป้องกัน
การ Handback ยังคงเป็นแนวปฏิบัติที่ยาวนานที่ Google และอาจเป็นการสาธิตที่ดีที่สุดของความเคารพซึ่งกันและกันระหว่างวิศวกร Dev และ Ops การทำเช่นนี้ช่วยให้ Development สร้างบริการใหม่ได้อย่างรวดเร็ว โดยมีวิศวกร Ops เข้าร่วมทีมเมื่อบริการมีความสำคัญเชิงกลยุทธ์ต่อบริษัท และในกรณีที่พบไม่บ่อย ก็ส่งคืนบริการเมื่อมันยุ่งยากเกินกว่าจะจัดการใน Production ** กรณีศึกษาต่อไปนี้ของ Site Reliability Engineering ที่ Google อธิบายว่ากระบวนการ Handoff Readiness Review และ Launch Readiness Review พัฒนาขึ้นมาอย่างไร และผลประโยชน์ที่เกิดขึ้น
กรณีศึกษา
The Launch and HandOff Readiness Review at Google (2010) (การทบทวนความพร้อมในการ Launch และ Handoff ที่ Google ปี 2010)
หนึ่งในข้อเท็จจริงที่น่าแปลกใจหลายอย่างเกี่ยวกับ Google คือพวกเขามีโครงสร้างองค์กรแบบเน้นหน้าที่สำหรับวิศวกร Ops ซึ่งเรียกว่า "Site Reliability Engineers" (SRE) ซึ่งเป็นคำที่ถูกบัญญัติขึ้นโดย Ben Treynor Sloss ในปี 2004 ในปีนั้น Treynor Sloss เริ่มต้นด้วยทีม SRE เพียงเจ็ดคน ซึ่งเติบโตขึ้นเป็นกว่า 1,200 คนภายในปี 2014 †† ดังที่ Treynor Sloss กล่าวว่า "ถ้า Google เคยล่ม มันเป็นความผิดของผม" Treynor Sloss ปฏิเสธที่จะให้คำจำกัดความ SRE แบบสั้น ๆ เพียงประโยคเดียว แต่เขาเคยอธิบายว่า SRE คือ "สิ่งที่เกิดขึ้นเมื่อวิศวกรซอฟต์แวร์ได้รับมอบหมายให้ทำงานที่เคยเรียกว่า operations" 12
SRE ทุกคนรายงานไปยังองค์กรของ Treynor Sloss เพื่อช่วยให้มั่นใจถึงความสม่ำเสมอของคุณภาพของบุคลากรและการจ้างงาน และพวกเขาจะถูกฝังเข้าไปในทีมผลิตภัณฑ์ต่าง ๆ ทั่ว Google (ซึ่งเป็นผู้ให้งบประมาณด้วย) อย่างไรก็ตาม SRE ยังคงมีจำนวนจำกัดมากจนถูกจัดสรรให้เฉพาะทีมผลิตภัณฑ์ที่มีความสำคัญสูงสุดต่อบริษัทหรือทีมที่ต้องปฏิบัติตามข้อกำหนดด้านกฎระเบียบเท่านั้น นอกจากนี้ บริการเหล่านั้นต้องมีภาระการดำเนินงานต่ำ ผลิตภัณฑ์ที่ไม่ตรงตามเกณฑ์ที่จำเป็นจะยังคงอยู่ในสถานะที่นักพัฒนาเป็นผู้ดูแล
แม้เมื่อผลิตภัณฑ์ใหม่มีความสำคัญต่อบริษัทมากพอที่จะสมควรได้รับ SRE นักพัฒนาก็ยังต้องดูแลบริการของตนเองใน Production เป็นเวลาอย่างน้อยหกเดือนก่อนที่จะมีสิทธิ์ได้รับ SRE มา Assign ให้ทีม 13
เพื่อช่วยให้มั่นใจว่าทีมผลิตภัณฑ์ที่ดูแลตนเองเหล่านี้ยังคงได้รับประโยชน์จากประสบการณ์ร่วมขององค์กร SRE Google ได้สร้างชุดตรวจสอบความปลอดภัยสองชุดสำหรับสองขั้นตอนสำคัญของการปล่อยบริการใหม่ เรียกว่า Launch Readiness Review และ Handoff Readiness Review (LRR และ HRR ตามลำดับ)
LRR ต้องดำเนินการและได้รับการอนุมัติก่อนที่บริการใหม่ของ Google จะเปิดให้ลูกค้าใช้งานได้และรับ Traffic Production จริง ในขณะที่ HRR จะดำเนินการเมื่อบริการถูกเปลี่ยนผ่านไปยังสถานะที่ Ops จัดการ ซึ่งมักจะหลายเดือนหลังจาก LRR รายการตรวจสอบ LRR และ HRR มีความคล้ายคลึงกัน แต่ HRR มีมาตรฐานที่เข้มงวดกว่าและมีเกณฑ์การยอมรับที่สูงกว่า ในขณะที่ LRR เป็นการรายงานตนเองโดยทีมผลิตภัณฑ์
ทีมผลิตภัณฑ์ใด ๆ ที่ผ่าน LRR หรือ HRR จะมี SRE ถูก Assign มาเพื่อช่วยให้พวกเขาเข้าใจข้อกำหนดและช่วยให้บรรลุข้อกำหนดเหล่านั้น รายการตรวจสอบ LRR และ HRR ได้รับการพัฒนาไปตามกาลเวลาเพื่อให้ทุกทีมได้รับประโยชน์จากประสบการณ์ร่วมของทุกการ Launch ที่ผ่านมา ไม่ว่าจะสำเร็จหรือไม่ก็ตาม Tom Limoncelli กล่าวไว้ในระหว่างการนำเสนอ "SRE@Google: Thousands of DevOps Since 2004" ในปี 2012 ว่า "ทุกครั้งที่เราทำ Launch เราจะเรียนรู้บางสิ่งบางอย่าง จะมีคนที่ประสบการณ์น้อยกว่าคนอื่น ๆ เสมอเมื่อต้องทำ Release และ Launch รายการตรวจสอบ LRR และ HRR คือวิธีการสร้างความทรงจำขององค์กรนั้น" 14
การกำหนดให้ทีมผลิตภัณฑ์ดูแลบริการของตนเองใน Production บังคับให้ Development สวมบทบาทของ Ops แต่อยู่ภายใต้การแนะนำของ LRR และ HRR ซึ่งไม่เพียงแต่ทำให้การเปลี่ยนผ่านบริการง่ายขึ้นและคาดการณ์ได้มากขึ้น แต่ยังช่วยสร้างความเห็นอกเห็นใจระหว่างศูนย์งานต้นน้ำและปลายน้ำ
Limoncelli กล่าวว่า "ในกรณีที่ดีที่สุด ทีมผลิตภัณฑ์ใช้รายการตรวจสอบ LRR เป็นแนวทาง ดำเนินการตามนั้นไปพร้อม ๆ กับการพัฒนาบริการของตน และติดต่อ SRE เพื่อขอความช่วยเหลือเมื่อต้องการ" 15
ยิ่งไปกว่านั้น Limoncelli ยังสังเกตว่า:
ทีมที่ได้รับการอนุมัติ Production ผ่าน HRR เร็วที่สุดคือทีมที่ทำงานกับ SRE เร็วที่สุด ตั้งแต่ช่วงออกแบบในระยะแรกเริ่มไปจนถึงการ Launch และสิ่งที่ดีคือ การหาอาสาสมัคร SRE มาช่วยโครงการของคุณนั้นง่ายเสมอ SRE ทุกคนเห็นคุณค่าของการให้คำแนะนำแก่ทีมโครงการตั้งแต่ช่วงต้น และมักจะอาสาสละเวลาไม่กี่ชั่วโมงหรือไม่กี่วันเพื่อทำเช่นนั้น 16
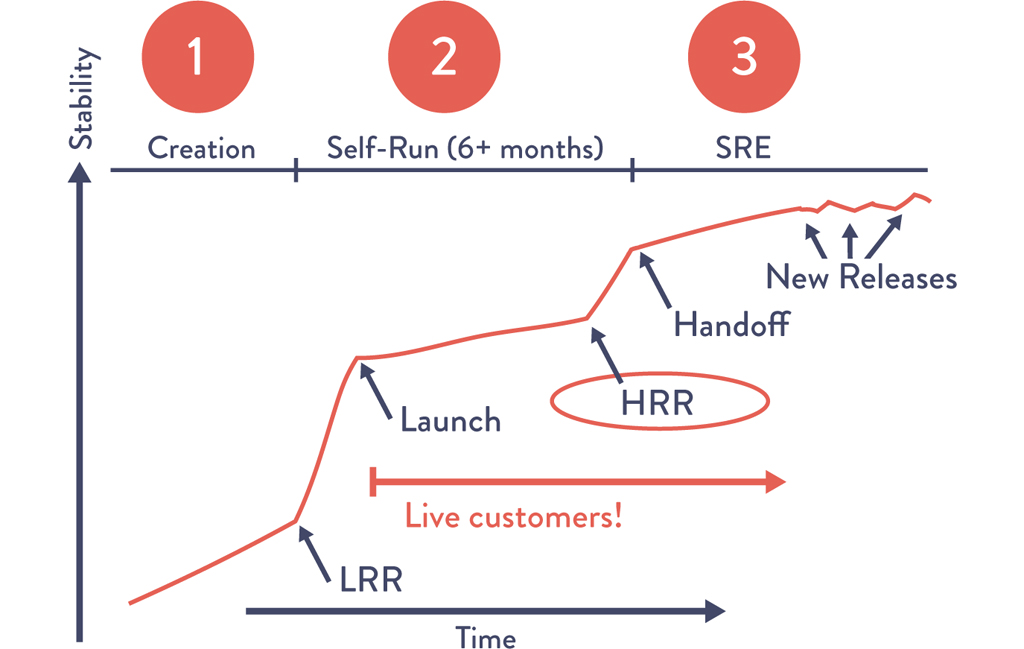
Figure 16.3: LRR และ HRR ที่ Google
ที่มา: "SRE@Google: Thousands of DevOps Since 2004," วิดีโอ YouTube, 45:57, โพสต์โดย USENIX, 12 มกราคม 2012, https://www.youtube.com/watch?v=iIuTnhdTzK0 .
การปฏิบัติที่ SRE ช่วยเหลือทีมผลิตภัณฑ์ตั้งแต่ช่วงต้นเป็นบรรทัดฐานทางวัฒนธรรมที่สำคัญซึ่งได้รับการเสริมกำลังอย่างต่อเนื่องที่ Google Limoncelli อธิบายว่า "การช่วยเหลือทีมผลิตภัณฑ์คือการลงทุนระยะยาวที่จะให้ผลตอบแทนหลายเดือนต่อมาเมื่อถึงเวลา Launch มันเป็นรูปแบบของ 'การเป็นพลเมืองที่ดี' และ 'การบริการชุมชน' ที่มีคุณค่า และถูกนำมาพิจารณาเป็นประจำเมื่อประเมินวิศวกรสำหรับการเลื่อนตำแหน่ง SRE" 17
ที่ Google การให้ทีมผลิตภัณฑ์ดูแลบริการของตนเองนำการเรียนรู้มาสู่ช่วงต้นของกระบวนการ ทำให้พวกเขาได้รับข้อมูลเชิงลึกอันมีค่าว่าโค้ดของพวกเขาทำงานอย่างไรภายใต้สภาพ Production จริง ปฏิบัตินี้ยังเสริมสร้างความสัมพันธ์และความเข้าใจระหว่าง Dev และ Ops สร้างวงจร Feedback ทางวัฒนธรรม
Conclusion (บทสรุป)
ในบทนี้ เราได้พูดถึงกลไก Feedback ที่ช่วยให้เราปรับปรุงบริการของเราในทุกขั้นตอนของงานประจำวัน ไม่ว่าจะเป็นการ Deploy การเปลี่ยนแปลงขึ้น Production การแก้ไขโค้ดเมื่อมีสิ่งผิดปกติและการแจ้งวิศวกร การให้นักพัฒนาติดตามงานไปยังปลายน้ำ การสร้าง Non-functional Requirements ที่ช่วยให้ทีมพัฒนาเขียนโค้ดที่พร้อมสำหรับ Production มากขึ้น หรือแม้แต่การส่งคืนบริการที่มีปัญหาให้ Development ดูแลตนเอง
การสร้าง Feedback Loops เหล่านี้ทำให้การ Deploy Production ปลอดภัยยิ่งขึ้น เพิ่มความพร้อมสำหรับ Production ของโค้ดที่สร้างโดย Development และช่วยสร้างความสัมพันธ์ในการทำงานที่ดีขึ้นระหว่าง Development และ Operations โดยการเสริมสร้างเป้าหมาย ความรับผิดชอบ และความเห็นอกเห็นใจร่วมกัน
ในบทถัดไป เราจะสำรวจว่า Telemetry สามารถช่วยให้เกิด Hypothesis-Driven Development และ A/B Testing เพื่อทำการทดลองที่ช่วยให้เราบรรลุเป้าหมายขององค์กรและชนะในตลาดได้อย่างไร