Alternatives to Business Domain Boundaries (ทางเลือกอื่นนอกจาก Business Domain Boundaries)
อย่างที่ ผมได้อธิบายไปแล้ว DDD สามารถมีประโยชน์อย่างมากเมื่อสร้างสถาปัตยกรรม microservice แต่จะเป็นความผิดพลาดถ้าคิดว่านี่เป็นเทคนิคเดียวที่คุณควรพิจารณาเมื่อหาขอบเขตของ microservice จริง ๆ แล้วผมมักใช้หลายวิธีร่วมกับ DDD เพื่อช่วยระบุว่าระบบควรถูกแบ่งอย่างไร (และควรแบ่งหรือไม่) มาดูปัจจัยอื่น ๆ ที่เราอาจพิจารณาเมื่อหาขอบเขตกัน
Volatility (ความผันผวน)
ผม ได้ยินเสียงคัดค้านต่อการแบ่งแบบมุ่งเน้น domain มากขึ้นเรื่อย ๆ มักมาจากผู้สนับสนุนที่มองว่าความผันผวน (volatility) เป็นตัวขับเคลื่อนหลักของการแบ่ง การแบ่งแบบอิงความผันผวนจะให้คุณระบุส่วนต่าง ๆ ของระบบที่มีการเปลี่ยนแปลงบ่อยกว่า แล้วดึงฟังก์ชันการทำงานนั้นออกไปเป็น service ของตัวเอง ซึ่งจะสามารถทำงานกับมันได้อย่างมีประสิทธิภาพมากขึ้น ในเชิงแนวคิด ผมไม่มีปัญหากับสิ่งนี้ แต่การส่งเสริมให้มันเป็นวิธีเดียวในการทำสิ่งต่าง ๆ นั้นไม่ค่อยมีประโยชน์นัก โดยเฉพาะเมื่อเราพิจารณาปัจจัยขับเคลื่อนที่แตกต่างกันที่อาจผลักดันเราไปสู่ microservices ยกตัวอย่างเช่น ถ้าปัญหาใหญ่ที่สุดของผมเกี่ยวข้องกับความจำเป็นในการ scale แอปพลิเคชันของผม การแบ่งแบบอิงความผันผวนก็ไม่น่าจะให้ประโยชน์มากนัก
แนวคิดเบื้องหลังการแบ่งแบบอิงความผันผวนยังปรากฏชัดในแนวทางอย่าง bimodal IT ด้วย แนวคิดที่ Gartner เสนอขึ้นมา bimodal IT แบ่งโลกออกเป็นหมวดหมู่ที่ตั้งชื่อได้ติดหูอย่าง "Mode 1" (หรือเรียกอีกอย่างว่า Systems of Record) และ "Mode 2" (หรือเรียกอีกอย่างว่า Systems of Innovation) โดยอิงจากว่าระบบต่าง ๆ ต้องเคลื่อนไหวเร็ว (หรือช้า) แค่ไหน เราถูกบอกว่าระบบ Mode 1 ไม่ค่อยเปลี่ยนแปลงมากนักและไม่ต้องการการมีส่วนร่วมจากฝ่ายธุรกิจมากนัก Mode 2 คือที่ที่มีความเคลื่อนไหว ด้วยระบบที่ต้องเปลี่ยนแปลงอย่างรวดเร็วและต้องการการมีส่วนร่วมอย่างใกล้ชิดจากฝ่ายธุรกิจ ถ้าเราลองมองข้ามการทำให้เรื่องซับซ้อนกลายเป็นเรื่องง่ายเกินไปที่มีอยู่ในแบบแผนการจัดหมวดหมู่แบบนี้ไปสักครู่ มันก็ยังบ่งบอกถึงมุมมองต่อโลกที่ค่อนข้างตายตัวมาก และขัดกับรูปแบบการเปลี่ยนแปลงที่เห็นได้ทั่วทั้งอุตสาหกรรมในขณะที่บริษัทต่าง ๆ พยายามจะ "go digital" ส่วนต่าง ๆ ของระบบบริษัทที่ในอดีตไม่จำเป็นต้องเปลี่ยนแปลงมากนัก จู่ ๆ ก็ต้องเปลี่ยน เพื่อเปิดโอกาสทางการตลาดใหม่ ๆ และให้บริการแก่ลูกค้าในแบบที่พวกเขาไม่เคยจินตนาการมาก่อน
กลับมาที่ MusicCorp กันอีกครั้ง ก้าวแรกของบริษัทเข้าสู่สิ่งที่ตอนนี้เราเรียกว่า digital ก็แค่การมีหน้าเว็บเพจ ทั้งหมดที่มันมีให้ในยุคกลางทศวรรษที่เก้าสิบก็แค่รายการสินค้าที่ขาย แต่คุณต้องโทรไปที่ MusicCorp เพื่อสั่งซื้อ มันแทบไม่ต่างจากโฆษณาในหนังสือพิมพ์เลย จากนั้นการสั่งซื้อออนไลน์ก็กลายเป็นเรื่องปกติ และคลังสินค้าทั้งหมด ซึ่งจนถึงตอนนั้นยังจัดการด้วยกระดาษ ก็ต้องถูกแปลงเป็นดิจิทัล ใครจะรู้ บางทีสักวันหนึ่ง MusicCorp อาจต้องพิจารณาทำให้เพลงพร้อมใช้งานแบบดิจิทัลก็ได้! แม้คุณอาจมองว่า MusicCorp ล้าหลังกว่ายุคสมัย คุณก็ยังสามารถเข้าใจถึงความปั่นป่วนอย่างมากที่บริษัทต่าง ๆ ต้องเผชิญ เมื่อพวกเขาเข้าใจว่าการเปลี่ยนแปลงของเทคโนโลยีและพฤติกรรมลูกค้าสามารถต้องการการเปลี่ยนแปลงที่สำคัญในส่วนต่าง ๆ ของธุรกิจที่คาดการณ์ล่วงหน้าได้ยาก
ผมไม่ชอบ bimodal IT ในฐานะแนวคิดหนึ่ง เพราะมันกลายเป็นวิธีที่คนใช้ทิ้งสิ่งที่เปลี่ยนแปลงยากลงในกล่องเรียบร้อยแล้วบอกว่า "เราไม่ต้องจัดการกับปัญหาในนั้นหรอก นั่นมันเป็น Mode 1" มันเป็นอีกโมเดลหนึ่งที่บริษัทสามารถนำมาใช้เพื่อให้แน่ใจว่าจริง ๆ แล้วไม่มีอะไรต้องเปลี่ยนแปลง มันยังหลีกเลี่ยงความจริงที่ว่าบ่อยครั้งการเปลี่ยนแปลงในฟังก์ชันการทำงานต้องการการเปลี่ยนแปลงใน "Systems of Record" (Mode 1) เพื่อให้เกิดการเปลี่ยนแปลงใน "Systems of Innovation" (Mode 2) ได้ จากประสบการณ์ของผม องค์กรที่นำ bimodal IT มาใช้มักจบลงด้วยการมีสองความเร็ว คือช้าและช้ากว่า
เพื่อความเป็นธรรมต่อผู้สนับสนุนการแบ่งแบบอิงความผันผวน หลายคนก็ไม่ได้แนะนำโมเดลที่เรียบง่ายเกินไปอย่าง bimodal IT เสมอไป จริง ๆ แล้วผมพบว่าเทคนิคนี้มีประโยชน์มากในการช่วยกำหนดขอบเขต ถ้าตัวขับเคลื่อนหลักคือเรื่องความเร็วในการออกสู่ตลาด การดึงฟังก์ชันการทำงานที่กำลังเปลี่ยนแปลงหรือต้องเปลี่ยนแปลงบ่อยออกมาก็สมเหตุสมผลอย่างยิ่งในสถานการณ์แบบนี้ แต่อีกครั้งหนึ่ง เป้าหมายเป็นตัวกำหนดกลไกที่เหมาะสมที่สุด
Data (ข้อมูล)
ธรรมชาติ ของข้อมูลที่คุณถือครองและจัดการสามารถผลักดันให้คุณไปสู่รูปแบบการแบ่งที่ต่างกันได้ ยกตัวอย่างเช่น คุณอาจต้องการจำกัดว่า service ใดจัดการข้อมูลที่สามารถระบุตัวบุคคลได้ (personally identifiable information หรือ PII) ทั้งเพื่อลดความเสี่ยงที่ข้อมูลจะรั่วไหลและเพื่อลดความซับซ้อนในการกำกับดูแลและ implement สิ่งอย่าง GDPR
สำหรับลูกค้ารายหนึ่งของผมเมื่อไม่นานมานี้ บริษัทด้านการชำระเงินที่เราจะเรียกว่า PaymentCo การใช้ข้อมูลบางประเภทส่งผลโดยตรงต่อการตัดสินใจที่เราทำเกี่ยวกับการแบ่งระบบ PaymentCo จัดการข้อมูลบัตรเครดิต ซึ่งหมายความว่าระบบของบริษัทต้องปฏิบัติตามข้อกำหนดต่าง ๆ ที่วางไว้โดยมาตรฐาน Payment Card Industry (PCI) สำหรับวิธีจัดการข้อมูลนี้ เป็นส่วนหนึ่งของการปฏิบัติตามข้อกำหนดนี้ ระบบและกระบวนการของบริษัทต้องถูกตรวจสอบ (audit) PaymentCo มีความจำเป็นต้องจัดการข้อมูลบัตรเครดิตแบบเต็มรูปแบบ และในปริมาณที่หมายความว่าระบบของบริษัทต้องปฏิบัติตาม PCI Level 1 ซึ่งเป็นระดับที่เข้มงวดที่สุดและต้องมีการประเมินจากภายนอกทุกไตรมาสเกี่ยวกับระบบและแนวปฏิบัติที่เกี่ยวข้องกับการจัดการข้อมูลนั้น
ข้อกำหนด PCI หลายอย่างเป็นสามัญสำนึกทั่วไป แต่การทำให้แน่ใจว่าทั้งระบบปฏิบัติตามข้อกำหนดเหล่านี้ โดยเฉพาะความจำเป็นที่ระบบต้องถูกตรวจสอบโดยบุคคลภายนอก กลับกลายเป็นภาระที่หนักมาก ด้วยเหตุนี้ บริษัทจึงต้องการแยกส่วนของระบบที่จัดการข้อมูลบัตรเครดิตแบบเต็มรูปแบบออกไป ซึ่งหมายความว่ามีเพียงส่วนย่อยของระบบเท่านั้นที่ต้องการการกำกับดูแลระดับเพิ่มเติมนี้ ใน Figure 2-17 เราจะเห็นรูปแบบที่ทำให้เรียบง่ายขึ้นของการออกแบบที่เราคิดค้นขึ้นมา Service ที่ทำงานอยู่ใน green zone (ล้อมรอบด้วยเส้นประสีเขียว) จะไม่เห็นข้อมูลบัตรเครดิตเลย ข้อมูลนั้นถูกจำกัดอยู่ที่ process (และเครือข่าย) ใน red zone (ล้อมรอบด้วยเส้นประสีแดง) เท่านั้น Gateway จะเปลี่ยนเส้นทางการเรียกไปยัง service ที่เหมาะสม (และ zone ที่เหมาะสม) เมื่อข้อมูลบัตรเครดิตผ่าน gateway นี้ มันก็ถือว่าอยู่ใน red zone ด้วยเช่นกัน
เนื่องจากข้อมูลบัตรเครดิตไม่เคยไหลเข้าไปใน green zone service ทั้งหมดในพื้นที่นี้จึงสามารถได้รับการยกเว้นจากการตรวจสอบ PCI แบบเต็มรูปแบบได้ Service ใน red zone อยู่ในขอบเขตของการกำกับดูแลแบบนั้น ระหว่างที่ทำการออกแบบ เราพยายามทำทุกอย่างเท่าที่ทำได้เพื่อจำกัดสิ่งที่ต้องอยู่ใน red zone นี้ สิ่งสำคัญที่ต้องสังเกตคือเราต้องมั่นใจว่าข้อมูลบัตรเครดิตจะไม่ไหลเข้าไปใน green zone เลย ถ้า microservice ใน green zone สามารถขอข้อมูลนี้ได้ หรือถ้าข้อมูลนั้นสามารถถูกส่งกลับไปที่ green zone โดย microservice ใน red zone แนวเส้นแบ่งที่ชัดเจนก็จะพังทลายลง
การแยกข้อมูลออกจากกันมักถูกขับเคลื่อนโดยข้อกังวลด้านความเป็นส่วนตัวและความปลอดภัยที่หลากหลาย เราจะกลับมาที่หัวข้อนี้และตัวอย่างของ PaymentCo อีกครั้งใน Chapter 11
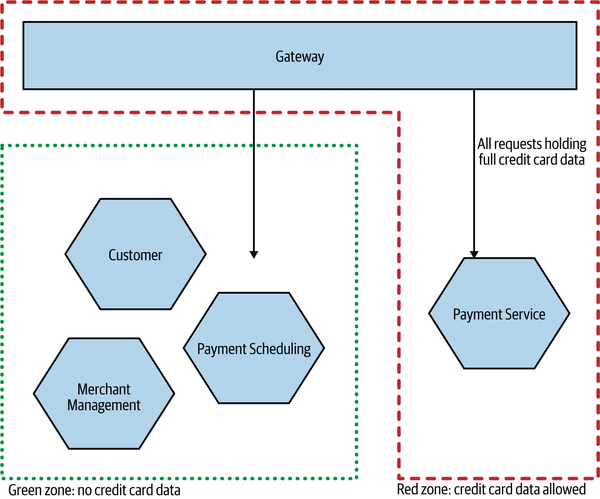
Figure 2-17. PaymentCo ซึ่งแยก process ตามการใช้ข้อมูลบัตรเครดิตเพื่อจำกัดขอบเขตของข้อกำหนด PCI
Technology (เทคโนโลยี)
ความจำเป็น ที่ต้องใช้เทคโนโลยีที่แตกต่างกันก็สามารถเป็นปัจจัยหนึ่งในการหาขอบเขตได้เช่นกัน คุณสามารถรองรับฐานข้อมูลที่ต่างกันภายใน microservice ที่กำลังรันอยู่ตัวเดียวได้ แต่ถ้าคุณต้องการผสม runtime model ที่ต่างกัน คุณอาจเจอกับความท้าทาย ถ้าคุณตัดสินใจว่าส่วนหนึ่งของฟังก์ชันการทำงานของคุณจำเป็นต้อง implement ด้วยภาษาอย่าง Rust ซึ่งช่วยให้คุณดึงประสิทธิภาพเพิ่มเติมออกมาได้ นั่นก็กลายเป็นปัจจัยผลักดันสำคัญ
แน่นอนว่าเราต้องตระหนักด้วยว่าสิ่งนี้อาจนำเราไปที่ไหนถ้านำมาใช้เป็นวิธีการแบ่งทั่วไป สถาปัตยกรรมแบบสามชั้น (three-tiered) แบบคลาสสิกที่เราพูดถึงในบทเปิดเรื่อง และที่เราแสดงให้เห็นอีกครั้งใน Figure 2-18 เป็นตัวอย่างของการนำเทคโนโลยีที่เกี่ยวข้องกันมาจัดกลุ่มไว้ด้วยกัน อย่างที่เราได้สำรวจไปแล้ว นี่มักเป็นสถาปัตยกรรมที่ไม่ค่อยเหมาะสมเท่าไรนัก
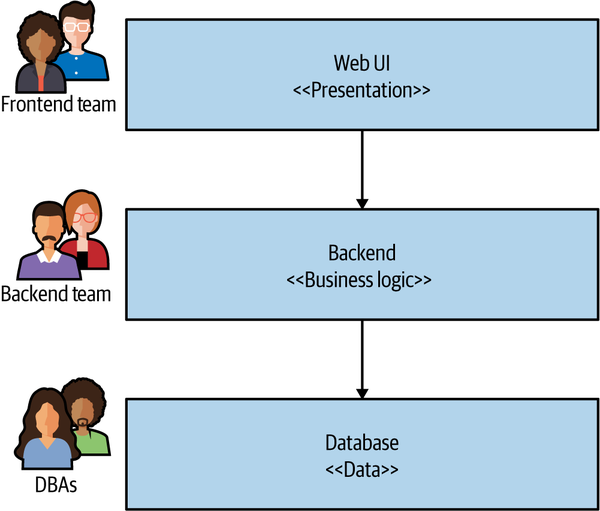
Figure 2-18. สถาปัตยกรรมแบบสามชั้นดั้งเดิมมักถูกขับเคลื่อนโดยขอบเขตด้านเทคโนโลยี
Organizational (โครงสร้างองค์กร)
อย่าง ที่เราได้กำหนดไว้เมื่อผมแนะนำ Conway's law ใน Chapter 1 มีความสัมพันธ์โดยธรรมชาติระหว่างโครงสร้างองค์กรกับสถาปัตยกรรมระบบที่คุณจะได้ในท้ายที่สุด นอกเหนือจากการศึกษาต่าง ๆ ที่แสดงให้เห็นความเชื่อมโยงนี้แล้ว จากประสบการณ์ส่วนตัวของผม ผมได้เห็นสิ่งนี้เกิดขึ้นซ้ำแล้วซ้ำเล่า วิธีที่คุณจัดองค์กรของตัวเองจะกลายเป็นตัวขับเคลื่อนสถาปัตยกรรมระบบของคุณ ไม่ว่าจะดีหรือร้าย เมื่อพูดถึงการช่วยกำหนดขอบเขตของ service เราต้องพิจารณาเรื่องนี้เป็นส่วนสำคัญของการตัดสินใจของเรา
การกำหนดขอบเขต service ที่ความเป็นเจ้าของตัดข้ามหลายทีมที่ต่างกันมักไม่ค่อยให้ผลลัพธ์ที่เราต้องการ อย่างที่เราจะสำรวจเพิ่มเติมใน Chapter 15 ความเป็นเจ้าของร่วมกันของ microservices เป็นเรื่องที่ยุ่งยากมาก ดังนั้นจึงสรุปได้ว่าเราต้องคำนึงถึงโครงสร้างองค์กรที่มีอยู่เมื่อพิจารณาว่าจะกำหนดขอบเขตที่ไหนและเมื่อไร และในบางสถานการณ์เราอาจต้องพิจารณาเปลี่ยนโครงสร้างองค์กรเองด้วยซ้ำเพื่อรองรับสถาปัตยกรรมที่เราต้องการ
แน่นอนว่าเราต้องพิจารณาด้วยว่าจะเกิดอะไรขึ้นถ้าโครงสร้างองค์กรของเราเปลี่ยนแปลงไปด้วย นั่นหมายความว่าตอนนี้เราต้องปรับสถาปัตยกรรมซอฟต์แวร์ของเราใหม่หรือเปล่า ในกรณีที่แย่ที่สุด มันอาจทำให้เราต้องตรวจสอบ microservice ที่มีอยู่ที่ตอนนี้จำเป็นต้องถูกแบ่ง เพราะมันมีฟังก์ชันการทำงานที่ตอนนี้อาจเป็นของสองทีมที่แยกกัน ในขณะที่ก่อนหน้านี้ทีมเดียวรับผิดชอบทั้งสองส่วน ในทางกลับกัน บ่อยครั้งการเปลี่ยนแปลงองค์กรก็แค่ต้องการให้เจ้าของ microservice ที่มีอยู่เปลี่ยนไปเท่านั้น ลองพิจารณาสถานการณ์ที่ทีมที่รับผิดชอบการดำเนินงานคลังสินค้าเคยจัดการฟังก์ชันการทำงานที่เกี่ยวกับการคำนวณว่าควรสั่งสินค้าจาก supplier กี่ชิ้นด้วย สมมติว่าเราตัดสินใจย้ายความรับผิดชอบนี้ไปให้ทีม forecasting เฉพาะทางที่ต้องการดึงข้อมูลจากยอดขายปัจจุบันและโปรโมชันที่วางแผนไว้เพื่อคำนวณว่าต้องสั่งอะไร ถ้าทีมคลังสินค้ามี microservice Supplier Ordering เฉพาะทางอยู่แล้ว มันก็แค่ย้ายไปให้ทีม forecasting ใหม่ได้เลย ในทางกลับกัน ถ้าฟังก์ชันการทำงานนี้เคยถูกรวมเข้ากับระบบที่มีขอบเขตกว้างกว่าซึ่งเป็นของทีมคลังสินค้า มันก็อาจจำเป็นต้องถูกแยกออกมา
แม้เมื่อเราทำงานภายในโครงสร้างองค์กรที่มีอยู่ ก็ยังมีความเสี่ยงที่เราจะไม่ได้กำหนดขอบเขตไว้ในตำแหน่งที่ถูกต้อง หลายปีก่อน ผมกับเพื่อนร่วมงานสองสามคนทำงานกับลูกค้ารายหนึ่งในแคลิฟอร์เนีย ช่วยให้บริษัทนำแนวปฏิบัติการเขียนโค้ดที่สะอาดขึ้นมาใช้และหันมาทำ automated testing มากขึ้น เราเริ่ม จากผลไม้ที่เก็บง่าย ๆ ก่อน เช่น การแบ่ง service เมื่อเราสังเกตเห็นบางอย่างที่น่าเป็นห่วงมากกว่านั้นมาก ผมไม่สามารถลงรายละเอียดมากนักว่าแอปพลิเคชันนั้นทำอะไร แต่มันเป็นแอปพลิเคชันที่เปิดให้สาธารณะใช้งานได้ พร้อมฐานลูกค้าทั่วโลกจำนวนมาก
ทีมงานและระบบเติบโตขึ้นเรื่อย ๆ เดิมทีเป็นวิสัยทัศน์ของคนคนเดียว ระบบก็ค่อย ๆ มีฟีเจอร์มากขึ้นเรื่อย ๆ และมีผู้ใช้มากขึ้นเรื่อย ๆ ในที่สุดองค์กรก็ตัดสินใจเพิ่มกำลังคนของทีมโดยให้กลุ่มนักพัฒนากลุ่มใหม่ที่ตั้งอยู่ในบราซิลรับงานบางส่วนไป ระบบถูกแบ่งออก โดยครึ่งหน้าของแอปพลิเคชันเป็นแบบ stateless โดยพื้นฐาน implement เว็บไซต์ที่เปิดให้สาธารณะใช้งาน ดังที่แสดงใน Figure 2-19 ครึ่งหลังของระบบเป็นเพียง interface แบบ remote procedure call (RPC) เหนือ data store เท่านั้น โดยพื้นฐานแล้วลองจินตนาการว่า คุณเอา repository layer ในโค้ดของคุณมาทำเป็น service แยกต่างหาก
การเปลี่ยนแปลงต้องเกิดขึ้นกับทั้งสอง service บ่อยครั้ง ทั้งสอง service สื่อสารกันด้วยการเรียก method แบบ RPC ระดับต่ำ ซึ่งเปราะบางเกินไป (เราจะพูดถึงเรื่องนี้เพิ่มเติมใน Chapter 4 ) Interface ของ service ก็สื่อสารกันถี่มากด้วย ส่งผลให้เกิดปัญหาด้านประสิทธิภาพ นี่นำไปสู่ความจำเป็นต้องมีกลไก RPC-batching ที่ซับซ้อน ผมเรียกสิ่งนี้ว่า "onion architecture" เพราะมันมีชั้นมากมายและทำให้ผมร้องไห้เมื่อต้องตัดผ่านมันไป
ทีนี้เมื่อมองผิวเผิน แนวคิดในการแบ่งระบบที่เคยเป็น monolithic ตามแนวภูมิศาสตร์/องค์กรก็ดูสมเหตุสมผลอย่างยิ่ง อย่างที่เราจะขยายความต่อไปใน Chapter 15 แต่ในกรณีนี้ แทนที่จะแบ่งแบบแนวตั้งที่มุ่งเน้นธุรกิจผ่าน stack ทีมงานกลับเลือกสิ่งที่เคยเป็น in-process API และทำการแบ่งแบบแนวนอนแทน โมเดลที่ดีกว่าคือให้ทีมในแคลิฟอร์เนียมี end-to-end vertical slice หนึ่งชิ้น ซึ่งประกอบด้วยส่วนที่เกี่ยวข้องของ frontend และฟังก์ชันการเข้าถึงข้อมูล โดยให้ทีมในบราซิลรับ slice อีกชิ้นหนึ่งไป
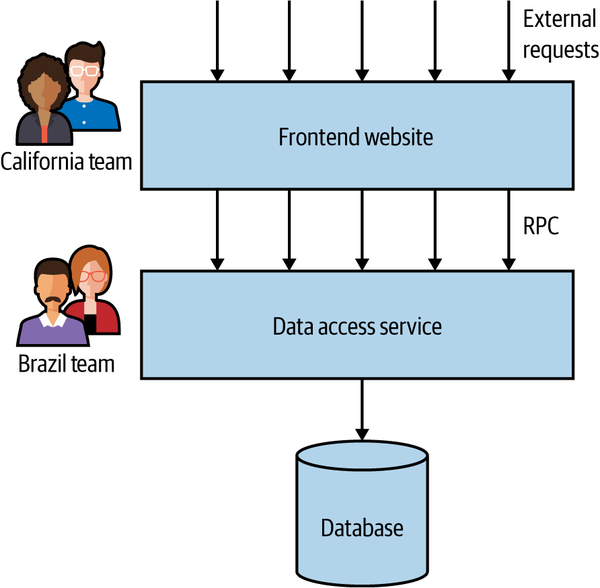
Figure 2-19. ขอบเขต service ที่ถูกแบ่งตามแนวรอยต่อทางเทคนิค
Layering Inside Versus Layering Outside (การแบ่งชั้นภายในเทียบกับการแบ่งชั้นภายนอก)
อย่าง ที่ผมหวังว่าตอนนี้คุณคงเห็นแล้วว่า ผมไม่ใช่แฟนของสถาปัตยกรรมแบบแบ่งชั้นในแนวนอน (horizontally layered) อย่างไรก็ตาม การแบ่งชั้นก็มีที่ทางของมันอยู่ ภายในขอบเขตของ microservice หนึ่งตัว มันสมเหตุสมผลอย่างยิ่งที่จะแบ่งเส้นระหว่างชั้นต่าง ๆ เพื่อทำให้โค้ดจัดการง่ายขึ้น ปัญหาเกิดขึ้นเมื่อการแบ่งชั้นนี้กลายเป็นกลไกที่ใช้ในการกำหนดขอบเขตของ microservice และความเป็นเจ้าของของคุณ