Just Enough Domain-Driven Design (Domain-Driven Design เท่าที่จำเป็น)
อย่างที่ ผมได้แนะนำไว้ใน Chapter 1 กลไกหลักที่เราใช้ในการหาขอบเขตของ microservice คือการดูที่ domain เอง โดยใช้ domain-driven design (DDD) ช่วยสร้างโมเดลของ domain ของเรา มาขยายความเข้าใจกันต่อว่า DDD ทำงานอย่างไรในบริบทของ microservices
ความต้องการที่จะให้โปรแกรมของเราสะท้อนโลกจริงที่มันจะทำงานอยู่ได้ดีขึ้นนั้นไม่ใช่เรื่องใหม่ ภาษาโปรแกรมเชิงวัตถุอย่าง Simula ถูกพัฒนาขึ้นเพื่อให้เราสร้างโมเดล domain จริงได้ แต่มันต้องการมากกว่าแค่ความสามารถของภาษาโปรแกรมเพื่อให้แนวคิดนี้เป็นรูปเป็นร่างขึ้นมาจริง ๆ
หนังสือ Domain-Driven Design 11 ของ Eric Evans นำเสนอชุดแนวคิดสำคัญที่ช่วยให้เราสะท้อน problem domain ในโปรแกรมของเราได้ดีขึ้น การสำรวจแนวคิดเหล่านี้อย่างเต็มรูปแบบนั้นอยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ แต่มีแนวคิดหลักบางอย่างของ DDD ที่ควรค่าแก่การเน้นย้ำ ได้แก่
Ubiquitous language (Ubiquitous Language)
การกำหนดและนำภาษากลางที่ใช้ร่วมกันมาใช้ทั้งในโค้ดและในการอธิบาย domain เพื่อช่วยในการสื่อสาร
Aggregate
กลุ่มของ object ที่ถูกจัดการเป็น entity เดียว ซึ่งโดยทั่วไปมักอ้างอิงถึงแนวคิดในโลกจริง
Bounded context
ขอบเขตที่ชัดเจนภายใน business domain ซึ่งให้ฟังก์ชันการทำงานแก่ระบบที่กว้างขึ้น แต่ก็ซ่อนความซับซ้อนไว้ด้วยเช่นกัน
Ubiquitous Language (ภาษาที่ใช้ร่วมกันทั่วทั้งระบบ)
Ubiquitous language หมายถึงแนวคิดที่ว่าเราควรพยายามใช้คำศัพท์เดียวกันในโค้ดกับที่ผู้ใช้งานใช้ แนวคิดนี้คือการมีภาษากลางระหว่างทีมพัฒนาและผู้ใช้งานจริงจะช่วยให้สร้างโมเดล domain ในโลกจริงได้ง่ายขึ้น และควรช่วยปรับปรุงการสื่อสารด้วย
ในฐานะตัวอย่างที่ตรงกันข้าม ผมจำได้ถึงสถานการณ์หนึ่งตอนทำงานที่ธนาคารระดับโลกขนาดใหญ่แห่งหนึ่ง เรากำลังทำงานในด้าน corporate liquidity ซึ่งเป็นศัพท์เก๋ ๆ ที่โดยพื้นฐานหมายถึงความสามารถในการโยกเงินสดระหว่างบัญชีต่าง ๆ ที่นิติบุคคลเดียวกันถืออยู่ Product owner นั้นทำงานด้วยได้ดีมาก และเธอมีความเข้าใจอย่างลึกซึ้งในผลิตภัณฑ์ต่าง ๆ ที่เธอต้องการนำออกสู่ตลาด เมื่อทำงานกับเธอ เราจะได้พูดคุยกันเรื่องอย่าง haircuts และ end-of-day sweeps ซึ่งเป็นสิ่งที่สมเหตุสมผลมากในโลกของเธอและมีความหมายกับลูกค้าของเธอ
ในทางกลับกัน โค้ดกลับไม่มีภาษาแบบนี้อยู่เลย ก่อนหน้านั้นมีการตัดสินใจให้ใช้ data model มาตรฐานสำหรับฐานข้อมูล ซึ่งเป็นที่รู้จักกันอย่างกว้างขวางในชื่อ "IBM banking model" แต่ผมก็ไม่แน่ใจว่านี่เป็นผลิตภัณฑ์มาตรฐานของ IBM จริง ๆ หรือเป็นแค่ผลงานของที่ปรึกษาจาก IBM คนหนึ่ง ด้วยการกำหนดแนวคิดกว้าง ๆ ของ "arrangement" ทฤษฎีก็คือการดำเนินการทางธนาคารใด ๆ ก็สามารถสร้างโมเดลได้ กู้เงินอยู่เหรอ นั่นก็คือ arrangement ซื้อหุ้นเหรอ นั่นก็เป็น arrangement เช่นกัน สมัครบัตรเครดิตเหรอ เดาสิว่าอะไร นั่นก็เป็น arrangement เหมือนกัน!
Data model นี้ได้ปนเปื้อนโค้ดจนถึงขนาดที่ codebase ขาดความเข้าใจที่แท้จริงเกี่ยวกับระบบที่เรากำลังสร้างไปเลย เราไม่ได้กำลังสร้างแอปพลิเคชันธนาคารทั่วไป เรากำลังสร้างระบบที่ออกแบบมาโดยเฉพาะเพื่อจัดการ corporate liquidity ปัญหาคือเราต้อง map ภาษา domain อันหลากหลายของ product owner ไปยังแนวคิดโค้ดทั่วไป ซึ่งหมายถึงงานจำนวนมากในการช่วยแปล นักวิเคราะห์ธุรกิจของเรามักใช้เวลาส่วนใหญ่ไปกับการอธิบายแนวคิดเดิม ๆ ซ้ำแล้วซ้ำเล่า
การนำภาษาในโลกจริงเข้ามาใส่ในโค้ดทำให้ทุกอย่างง่ายขึ้นมาก นักพัฒนาที่หยิบ story ที่เขียนด้วยคำศัพท์ที่มาจาก product owner โดยตรง มีแนวโน้มที่จะเข้าใจความหมายและคิดออกว่าต้องทำอะไรได้ง่ายกว่ามาก
Aggregate (Aggregate)
ใน DDD aggregate เป็นแนวคิดที่ค่อนข้างสับสน มีคำจำกัดความมากมายที่แตกต่างกัน มันคือกลุ่มของ object แบบใดก็ได้หรือเปล่า หรือหน่วยที่เล็กที่สุดที่ควรดึงออกมาจากฐานข้อมูล โมเดลที่ใช้ได้ผลกับผมเสมอมาคือการมอง aggregate เป็นตัวแทนของแนวคิด domain จริง ๆ ในตอนแรก ลองนึกถึงสิ่งอย่าง Order, Invoice, Stock Item และอื่น ๆ Aggregates โดยทั่วไปมักมี life cycle รอบตัวมัน ซึ่งเปิดโอกาสให้ implement มันเป็น state machine ได้
ตัวอย่างใน domain ของ MusicCorp aggregate ของ Order อาจมี line item หลายรายการที่แสดงถึงสินค้าในคำสั่งซื้อนั้น line item เหล่านี้มีความหมายก็ต่อเมื่อเป็นส่วนหนึ่งของ aggregate ของ Order โดยรวมเท่านั้น
เราต้องการปฏิบัติต่อ aggregates เป็นหน่วยที่พึ่งพาตัวเองได้ (self-contained) เราต้องการให้แน่ใจว่าโค้ดที่จัดการการเปลี่ยนสถานะของ aggregate นั้นถูกจัดกลุ่มไว้ด้วยกัน พร้อมกับ state เอง ดังนั้น aggregate หนึ่งควรถูกจัดการโดย microservice เดียว แม้ว่า microservice เดียวอาจเป็นเจ้าของการจัดการ aggregates หลายตัวก็ได้
อย่างไรก็ตาม โดยทั่วไปแล้วคุณควรมอง aggregate เป็นสิ่งที่มี state, identity และ life cycle ที่จะถูกจัดการเป็นส่วนหนึ่งของระบบ Aggregates โดยทั่วไปมักอ้างอิงถึงแนวคิดในโลกจริง
Microservice เดียวจะจัดการ life cycle และการจัดเก็บข้อมูลของ aggregate ประเภทเดียวหรือหลายประเภท ถ้าฟังก์ชันการทำงานใน service อื่นต้องการเปลี่ยนแปลง aggregate ตัวใดตัวหนึ่งนี้ มันจำเป็นต้องขอเปลี่ยนแปลง aggregate นั้นโดยตรง หรือไม่ก็ต้องให้ aggregate เองตอบสนองต่อสิ่งอื่น ๆ ในระบบเพื่อเริ่มการเปลี่ยนสถานะของตัวเอง เช่น การ subscribe เหตุการณ์ที่ถูกส่งออกมาจาก microservice อื่น
สิ่งสำคัญที่ต้องเข้าใจตรงนี้คือ ถ้ามีบุคคลภายนอกร้องขอให้เปลี่ยนสถานะของ aggregate นั้น aggregate สามารถปฏิเสธได้ โดยหลักการแล้วคุณอยากจะ implement aggregates ของคุณในแบบที่การเปลี่ยนสถานะที่ไม่ถูกต้องเป็นไปไม่ได้เลย
Aggregates สามารถมีความสัมพันธ์กับ aggregates อื่นได้ ใน Figure 2-12 เรามี aggregate ของ Customer ที่เชื่อมโยงกับ Order หนึ่งรายการหรือมากกว่า และ Wishlist หนึ่งรายการหรือมากกว่า Aggregates เหล่านี้อาจถูกจัดการโดย microservice เดียวกันหรือคนละ microservice ก็ได้
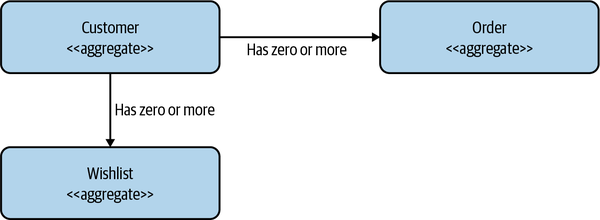
Figure 2-12. Aggregate ของ Customer หนึ่งตัวอาจเชื่อมโยงกับ aggregate ของ Order หรือ Wishlist หนึ่งตัวหรือมากกว่า
ถ้าความสัมพันธ์เหล่านี้ระหว่าง aggregates อยู่ภายในขอบเขตของ microservice เดียวกัน ก็สามารถจัดเก็บได้ง่าย ๆ โดยใช้อะไรอย่าง foreign key relationship ถ้าใช้ relational database แต่ถ้าความสัมพันธ์ระหว่าง aggregates เหล่านี้ข้ามขอบเขต microservice เราก็จำเป็นต้องมีวิธีสร้างโมเดลความสัมพันธ์เหล่านั้น
ทีนี้เราอาจแค่จัดเก็บ ID ของ aggregate ไว้โดยตรงในฐานข้อมูลของเราเอง ยกตัวอย่างเช่น ลองพิจารณา Finance microservice ที่จัดการ financial ledger ซึ่งเก็บ transaction ต่าง ๆ ของลูกค้า ในฐานข้อมูลของ Finance microservice เอง เราอาจมีคอลัมน์ CustID ที่เก็บ ID ของลูกค้ารายนั้น ถ้าเราต้องการข้อมูลเพิ่มเติมเกี่ยวกับลูกค้ารายนั้น เราก็ต้องไป lookup กับ Customer microservice โดยใช้ ID นั้น
ปัญหาของแนวคิดนี้คือมันไม่ค่อยชัดเจนนัก จริง ๆ แล้วความสัมพันธ์ระหว่างคอลัมน์ CustID กับ customer ที่อยู่ในระบบอื่นเป็นความสัมพันธ์แบบซ่อนเร้น (implicit) ทั้งหมด ถ้าจะรู้ว่า ID นั้นถูกใช้งานอย่างไร เราต้องไปดูโค้ดของ Finance microservice เองเท่านั้น จะดีกว่าถ้าเราสามารถจัดเก็บการอ้างอิงไปยัง foreign aggregate ในแบบที่ชัดเจนกว่านี้ได้
ใน Figure 2-13 เราได้เปลี่ยนแปลงบางอย่างเพื่อทำให้ความสัมพันธ์ชัดเจนขึ้น แทนที่จะใช้ ID ธรรมดาสำหรับการอ้างอิงลูกค้า เรากลับจัดเก็บ URI แทน ซึ่งเราอาจใช้ถ้าเรากำลังสร้างระบบแบบ REST-based 12
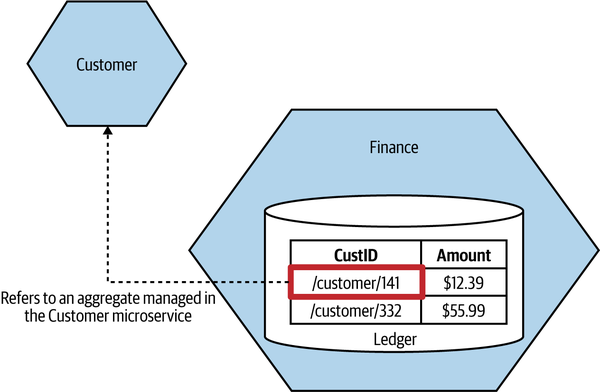
Figure 2-13. ตัวอย่างวิธีการ implement ความสัมพันธ์ระหว่าง aggregates สองตัวใน microservices ที่ต่างกัน
ประโยชน์ของแนวทางนี้มีสองอย่าง ธรรมชาติของความสัมพันธ์นั้นชัดเจน และในระบบ REST เราสามารถ dereference URI นี้โดยตรงเพื่อ lookup resource ที่เกี่ยวข้องได้ แต่ถ้าคุณไม่ได้กำลังสร้างระบบ REST ล่ะ Phil Calçado อธิบายรูปแบบหนึ่งของแนวทางนี้ที่ใช้ที่ SoundCloud 13 ซึ่งพวกเขาพัฒนา pseudo-URI scheme สำหรับการอ้างอิงข้าม service ยกตัวอย่างเช่น soundcloud:tracks:123 จะเป็นการอ้างอิงไปยัง track ที่มี ID เป็น 123 ซึ่งชัดเจนกว่ามากสำหรับมนุษย์ที่ดู identifier นี้ และก็ยังเป็น scheme ที่มีประโยชน์มากพอที่จะจินตนาการได้ง่ายว่าสามารถสร้างโค้ดที่ช่วยให้การ lookup aggregate ข้าม microservice ทำได้ง่ายขึ้นถ้าจำเป็น
มีหลายวิธีในการแบ่งระบบออกเป็น aggregates โดยบางทางเลือกก็ค่อนข้างเป็นเรื่องส่วนตัว (subjective) คุณอาจตัดสินใจปรับรูปร่างของ aggregates ใหม่ตามกาลเวลา ด้วยเหตุผลด้านประสิทธิภาพหรือความง่ายในการ implement ผมมองว่าข้อกังวลด้าน implementation เป็นเรื่องรอง อย่างไรก็ตาม ผมเริ่มต้นด้วยการปล่อยให้ mental model ของผู้ใช้งานระบบเป็นแสงนำทางในการออกแบบเบื้องต้น จนกว่าปัจจัยอื่น ๆ จะเข้ามาเกี่ยวข้อง
Bounded Context (Bounded Context)
A bounded context โดยทั่วไปเป็นตัวแทนของขอบเขตเชิงองค์กรที่ใหญ่กว่า ภายในขอบเขตนั้น จำเป็นต้องมีความรับผิดชอบที่ชัดเจนที่ต้องดำเนินการ นี่ยังฟังดูค่อนข้างคลุมเครือ ลองมาดูตัวอย่างที่เจาะจงกว่านี้กัน
ที่ MusicCorp คลังสินค้าของเราเป็นแหล่งกิจกรรมที่คึกคัก มีการจัดการคำสั่งซื้อที่ถูกจัดส่งออกไป (และการคืนของบ้างเป็นบางครั้ง) รับสินค้าใหม่เข้ามา แข่งรถโฟล์คลิฟท์กันเล่น ๆ และอื่น ๆ ในที่อื่น แผนกการเงินอาจสนุกน้อยกว่า แต่ก็ยังมีหน้าที่สำคัญภายในองค์กรของเรา จัดการเรื่องเงินเดือน จ่ายค่าขนส่ง และอื่น ๆ ในทำนองเดียวกัน
Bounded contexts ซ่อนรายละเอียดการ implement เอาไว้ มีข้อกังวลภายในบางอย่าง เช่น ประเภทของรถโฟล์คลิฟท์ที่ใช้อยู่ ซึ่งไม่มีใครสนใจนอกจากคนในคลังสินค้า ข้อกังวลภายในเหล่านี้ควรถูกซ่อนจากโลกภายนอก ซึ่งไม่จำเป็นต้องรู้ และไม่ควรต้องสนใจด้วย
จากมุมมองด้าน implementation bounded contexts จะมี aggregate หนึ่งตัวหรือมากกว่าอยู่ภายใน aggregates บางตัวอาจถูกเปิดเผยออกไปนอก bounded context บางตัวอาจถูกซ่อนไว้ภายใน เช่นเดียวกับ aggregates bounded contexts ก็อาจมีความสัมพันธ์กับ bounded contexts อื่นได้ เมื่อ map เข้ากับ service dependency เหล่านี้ก็จะกลายเป็น inter-service dependency
ลองย้อนกลับไปที่ธุรกิจของ MusicCorp กันสักครู่ Domain ของเราคือธุรกิจทั้งหมดที่เรากำลังดำเนินอยู่ มันครอบคลุมทุกอย่างตั้งแต่คลังสินค้าไปจนถึงโต๊ะต้อนรับ จากการเงินไปจนถึงการสั่งซื้อ เราอาจสร้างโมเดลทั้งหมดนี้ในซอฟต์แวร์ของเราหรือไม่ก็ได้ แต่ไม่ว่าจะอย่างไรนั่นก็คือ domain ที่เรากำลังดำเนินงานอยู่ มาลองคิดถึงส่วนต่าง ๆ ของ domain นั้นที่ดูเหมือน bounded contexts ที่ Eric Evans อ้างถึงกัน
Hidden models (โมเดลที่ซ่อนอยู่)
สำหรับ MusicCorp เราสามารถพิจารณาให้แผนกการเงินและคลังสินค้าเป็น bounded contexts ที่แยกจากกันสองแห่ง ทั้งสองแห่งต่างมี interface ที่ชัดเจนต่อโลกภายนอก (ในแง่ของรายงานสินค้าคงคลัง สลิปเงินเดือน ฯลฯ) และมีรายละเอียดที่มีแต่ตัวเองเท่านั้นที่จำเป็นต้องรู้ (รถโฟล์คลิฟท์ เครื่องคิดเลข)
แผนกการเงินไม่จำเป็นต้องรู้การทำงานภายในโดยละเอียดของคลังสินค้า แต่ก็จำเป็นต้องรู้ บางอย่าง เช่น จำเป็นต้องรู้ระดับสต็อกเพื่อให้บัญชีเป็นปัจจุบัน Figure 2-14 แสดงตัวอย่าง context diagram เราจะเห็นแนวคิดที่เป็นเรื่องภายในของคลังสินค้า อย่าง picker (คนที่หยิบสินค้าตามคำสั่งซื้อ) ชั้นวางที่แสดงตำแหน่งสต็อก และอื่น ๆ ในทำนองเดียวกัน รายการใน general ledger ก็เป็นส่วนสำคัญของฝ่ายการเงิน แต่ไม่ได้ถูกแชร์ออกไปภายนอกในที่นี้
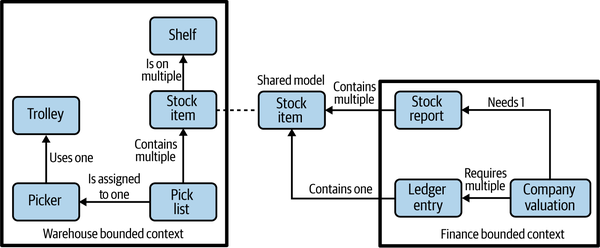
Figure 2-14. โมเดลที่ใช้ร่วมกันระหว่างแผนกการเงินและคลังสินค้า
แต่เพื่อให้สามารถคำนวณมูลค่าของบริษัทได้ พนักงานฝ่ายการเงินจำเป็นต้องมีข้อมูลเกี่ยวกับสต็อกที่เราถืออยู่ Stock item จึงกลายเป็นโมเดลที่ใช้ร่วมกันระหว่างสอง context อย่างไรก็ตาม โปรดสังเกตว่าเราไม่จำเป็นต้องเปิดเผยทุกอย่างเกี่ยวกับ stock item จาก warehouse context แบบไม่เลือก ใน Figure 2-15 เราจะเห็นว่า Stock Item ภายใน warehouse bounded context มีการอ้างอิงไปยังตำแหน่งชั้นวาง แต่ representation ที่ใช้ร่วมกันมีเพียงจำนวนนับเท่านั้น ดังนั้นจึงมี representation แบบภายในเท่านั้นและ representation ภายนอกที่เราเปิดเผย บ่อยครั้งเมื่อคุณมี representation ภายในและภายนอกที่ต่างกัน อาจเป็นประโยชน์ที่จะตั้งชื่อให้ต่างกันเพื่อหลีกเลี่ยงความสับสน ในสถานการณ์นี้ แนวทางหนึ่งคือเรียก Stock Item ที่ใช้ร่วมกันว่า Stock Count แทน
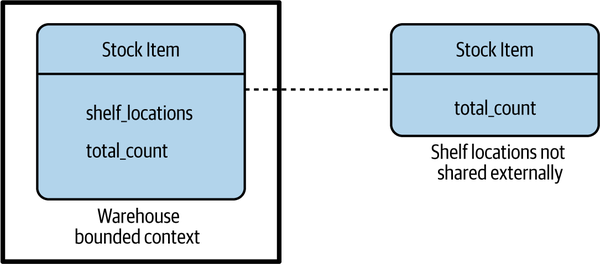
Figure 2-15. โมเดลที่ใช้ร่วมกันสามารถเลือกซ่อนข้อมูลที่ไม่ควรถูกแชร์ออกไปภายนอกได้
Shared models (โมเดลที่ใช้ร่วมกัน)
เรา ยังสามารถมีแนวคิดที่ปรากฏอยู่ในมากกว่าหนึ่ง bounded context ได้ ใน Figure 2-14 เราเห็นว่า Stock Item มีอยู่ในทั้งสองที่ นี่หมายความว่าอย่างไร Stock Item ถูกคัดลอกหรือเปล่า วิธีคิดเรื่องนี้คือในเชิงแนวคิด ทั้งฝ่ายการเงินและคลังสินค้าต่างต้องการรู้บางอย่างเกี่ยวกับ Stock Item ตัวเดียวกัน ฝ่ายการเงินจำเป็นต้องรู้มูลค่าของสต็อกของเราเพื่อกำหนดมูลค่าบริษัท ในขณะที่คลังสินค้าจำเป็นต้องรู้เกี่ยวกับ stock item เพื่อรู้ว่าสามารถหาสิ่งของจริงได้ที่ไหนในคลังสินค้าเพื่อจุดประสงค์ในการบรรจุคำสั่งซื้อที่จะส่งออกไป
เมื่อคุณมีสถานการณ์แบบนี้ โมเดลที่ใช้ร่วมกันอย่าง stock item อาจมีความหมายที่ต่างกันใน bounded context ที่ต่างกัน และด้วยเหตุนี้อาจถูกเรียกด้วยชื่อที่ต่างกันด้วย เราอาจพอใจที่จะเก็บชื่อ "stock item" ไว้ในคลังสินค้า แต่ในฝ่ายการเงินเราอาจเรียกมันแบบทั่วไปมากขึ้นว่า "asset" เพราะนั่นคือบทบาทที่มันมีใน context นั้น เราจัดเก็บข้อมูลเกี่ยวกับ stock item ในทั้งสองที่ แต่ข้อมูลนั้นต่างกัน ฝ่ายการเงินจัดเก็บข้อมูลเกี่ยวกับมูลค่าของ stock item ส่วนคลังสินค้าจัดเก็บข้อมูลที่เกี่ยวข้องกับตำแหน่งที่พบสินค้านั้น เรายังอาจต้องเชื่อมโยงแนวคิดในระดับท้องถิ่นทั้งสองเข้ากับแนวคิดระดับ global ของสินค้านั้น และเราอาจต้องการ lookup ข้อมูลที่ใช้ร่วมกันของ stock item นั้น เช่น ชื่อหรือ supplier เราสามารถใช้เทคนิคอย่างที่แสดงใน Figure 2-13 เพื่อจัดการการ lookup เหล่านี้ได้
Mapping Aggregates and Bounded Contexts to Microservices (การ Map Aggregates และ Bounded Contexts เข้ากับ Microservices)
ทั้ง aggregate และ bounded context ต่างมอบหน่วยของ cohesion ที่มี interface ที่ชัดเจนกับระบบที่กว้างกว่าให้กับเรา Aggregate เป็น state machine ที่พึ่งพาตัวเองได้ซึ่งมุ่งเน้นไปที่แนวคิด domain เดียวในระบบของเรา โดยที่ bounded context เป็นตัวแทนของกลุ่ม aggregates ที่เกี่ยวข้องกัน ซึ่งก็มี interface ที่ชัดเจนต่อโลกที่กว้างกว่าเช่นกัน
ทั้งสองอย่างจึงสามารถทำงานได้ดีในฐานะขอบเขตของ service เมื่อเริ่มต้น อย่างที่ผมได้กล่าวไปแล้ว คุณอยากลดจำนวน service ที่คุณทำงานด้วยลง ด้วยเหตุนี้ คุณควรตั้งเป้าไปที่ service ที่ครอบคลุม bounded context ทั้งหมด เมื่อคุณเริ่มจับทางได้และตัดสินใจแบ่ง service เหล่านี้ออกเป็น service ที่เล็กลง คุณต้องจำไว้ว่า aggregates เองไม่อยากถูกแบ่งแยกออกจากกัน microservice หนึ่งสามารถจัดการ aggregate หนึ่งตัวหรือมากกว่าได้ แต่เราไม่ต้องการให้ aggregate ตัวเดียวถูกจัดการโดย microservice มากกว่าหนึ่งตัว
Turtles all the way down (เต่าซ้อนเต่าไปเรื่อย ๆ)
ในตอนเริ่มต้น คุณอาจระบุ bounded context แบบหยาบ (coarse-grained) ได้จำนวนหนึ่ง แต่ bounded contexts เหล่านี้ก็อาจมี bounded contexts ย่อยอยู่ภายในอีกทีได้ ยกตัวอย่างเช่น คุณอาจแบ่งคลังสินค้าออกเป็นความสามารถที่เกี่ยวข้องกับ order fulfillment, inventory management หรือ goods receiving เมื่อพิจารณาขอบเขตของ microservices ของคุณ ให้เริ่มคิดในแง่ของ context ที่ใหญ่และหยาบกว่าก่อน แล้วค่อยแบ่งย่อยตาม nested context เหล่านี้เมื่อคุณกำลังมองหาประโยชน์จากการแยกจุดต่อเชื่อมเหล่านี้ออกจากกัน
เคล็ดลับตรงนี้คือแม้ว่าคุณจะตัดสินใจแบ่ง service ที่สร้างโมเดลของ bounded context ทั้งหมดออกเป็น service ที่เล็กลงในภายหลัง คุณก็ยังสามารถซ่อนการตัดสินใจนี้จากโลกภายนอกได้ อาจจะโดยการนำเสนอ API แบบหยาบกว่าให้กับ consumer การตัดสินใจแบ่ง service ออกเป็นส่วนย่อย ๆ ก็เป็นการตัดสินใจด้าน implementation อย่างหนึ่ง ดังนั้นเราจึงควรซ่อนมันไว้ถ้าทำได้ ใน Figure 2-16 เราจะเห็นตัวอย่างของสิ่งนี้ เราได้แบ่ง Warehouse ออกเป็น Inventory และ Shipping สำหรับโลกภายนอกแล้ว ยังคงมีแค่ microservice Warehouse เท่านั้น แต่ภายในเราได้แบ่งย่อยต่อไปอีกเพื่อให้ Inventory จัดการ Stock Items และให้ Shipping จัดการ Shipments จำไว้ว่าเราต้องการรักษาความเป็นเจ้าของ aggregate ตัวเดียวให้อยู่ภายใน microservice เดียว
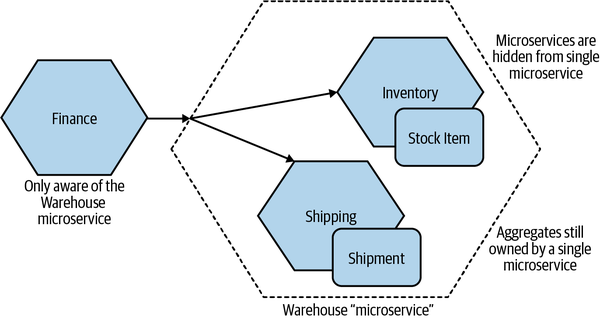
Figure 2-16. Service Warehouse ภายในได้ถูกแบ่งออกเป็น microservices Inventory และ Shipping
นี่เป็นอีกรูปแบบหนึ่งของ information hiding เราได้ซ่อนการตัดสินใจเกี่ยวกับ implementation ภายในในแบบที่ถ้ารายละเอียด implementation นี้เปลี่ยนแปลงอีกในอนาคต consumer ของเราก็จะไม่รับรู้เลย
อีกเหตุผลหนึ่งที่ควรเลือกใช้แนวทางแบบ nested คือการรวมกลุ่มสถาปัตยกรรมของคุณเพื่อทำให้การทดสอบง่ายขึ้น ยกตัวอย่างเช่น เมื่อทดสอบ service ที่ใช้งาน warehouse ผมไม่ต้อง stub แต่ละ service ภายใน warehouse context เลย แค่ API ที่หยาบกว่าก็พอ นี่ยังให้หน่วยของการแยกตัว (isolation) แก่คุณเมื่อพิจารณาการทดสอบขอบเขตที่กว้างขึ้นได้ด้วย ยกตัวอย่างเช่น ผมอาจตัดสินใจมี end-to-end test ที่รัน service ทั้งหมดภายใน warehouse context แต่สำหรับ collaborator อื่น ๆ ทั้งหมดผมอาจ stub มันออกไป เราจะสำรวจเรื่องการทดสอบและ isolation กันต่อไปใน Chapter 9
Event Storming (Event Storming)
Event storming เป็น เทคนิคที่พัฒนาโดย Alberto Brandolini เป็นกิจกรรมระดมความคิดแบบร่วมมือกันที่ออกแบบมาเพื่อช่วยดึงเอา domain model ออกมาให้เห็นชัดเจน แทนที่จะให้สถาปนิกนั่งอยู่คนเดียวในมุมห้องแล้วคิดค้น representation ของ domain model ขึ้นมาเอง 14 event storming นำผู้มีส่วนได้ส่วนเสียทั้งฝ่ายเทคนิคและไม่ใช่เทคนิคมารวมกันในกิจกรรมร่วมกัน แนวคิดคือการทำให้การพัฒนา domain model เป็นกิจกรรมร่วมกันจะทำให้คุณได้มุมมองของโลกที่ใช้ร่วมกันและเชื่อมโยงกัน
ควรกล่าวไว้ตรงนี้ด้วยว่าแม้ domain model ที่ถูกกำหนดผ่าน event storming จะสามารถนำไปใช้ implement ระบบแบบ event-driven ได้ และแท้จริงแล้วการ map นั้นก็ตรงไปตรงมามาก คุณก็ยังสามารถใช้ domain model แบบนี้เพื่อสร้างระบบที่เน้น request/response มากกว่าได้เช่นกัน
Logistics (การจัดการด้านโลจิสติกส์)
Alberto มีมุมมองที่ค่อนข้างเฉพาะเจาะจงว่า event storming ควรจัดอย่างไร และในบางประเด็นผมก็เห็นด้วยเป็นอย่างมาก อย่างแรกคือให้ทุกคนมารวมตัวกันในห้องเดียวกัน นี่มักเป็นขั้นตอนที่ยากที่สุด การจัดตารางเวลาของทุกคนให้ตรงกันอาจเป็นปัญหา เช่นเดียวกับการหาห้องที่ใหญ่พอ ปัญหาเหล่านี้ล้วนเป็นจริงในโลกก่อน COVID แต่ในขณะที่ผมเขียนสิ่งนี้ระหว่างการล็อกดาวน์จากไวรัสในสหราชอาณาจักร ผมตระหนักว่าขั้นตอนนี้อาจเป็นปัญหามากขึ้นไปอีกในอนาคต อย่างไรก็ตาม สิ่งสำคัญคือต้องมีผู้มีส่วนได้ส่วนเสียทุกคนอยู่พร้อมกันในเวลาเดียวกัน คุณต้องการตัวแทนจากทุกส่วนของ domain ที่คุณวางแผนจะสร้างโมเดล ไม่ว่าจะเป็นผู้ใช้งาน ผู้เชี่ยวชาญในเนื้อหา product owner หรือใครก็ตามที่เหมาะสมที่สุดที่จะเป็นตัวแทนของแต่ละส่วนของ domain
เมื่อทุกคนมารวมตัวกันในห้องแล้ว Alberto แนะนำให้เอาเก้าอี้ออกทั้งหมดเพื่อให้แน่ใจว่าทุกคนลุกขึ้นยืนและมีส่วนร่วม ในฐานะคนที่มีปัญหาหลัง แม้ผมจะเข้าใจกลยุทธ์นี้ แต่ผมก็ตระหนักว่ามันอาจไม่ได้ผลกับทุกคน สิ่งหนึ่งที่ผมเห็นด้วยกับ Alberto คือความจำเป็นที่ต้องมีพื้นที่กว้างขวางสำหรับทำ modeling ได้ วิธีแก้ปัญหาทั่วไปคือการติดกระดาษสีน้ำตาลม้วนใหญ่ไว้บนผนังห้อง ทำให้สามารถใช้ผนังทั้งหมดในการบันทึกข้อมูลได้
เครื่องมือหลักในการทำ modeling คือ sticky note เพื่อบันทึกแนวคิดต่าง ๆ โดยใช้ note ที่มีสีต่างกันเพื่อแสดงแนวคิดที่ต่างกัน
The process (กระบวนการ)
กิจกรรม เริ่มต้นด้วยการให้ผู้เข้าร่วมระบุ domain events ซึ่งเป็นตัวแทนของสิ่งที่เกิดขึ้นในระบบ นั่นคือข้อเท็จจริงที่คุณสนใจ "Order Placed" จะเป็นเหตุการณ์ที่เราสนใจในบริบทของ MusicCorp เช่นเดียวกับ "Payment Received" สิ่งเหล่านี้ถูกบันทึกบน sticky note สีส้ม ตรงนี้เองที่ผมมีความเห็นต่างอีกอย่างหนึ่งกับโครงสร้างของ Alberto เพราะ event เป็นสิ่งที่คุณจะบันทึกมากที่สุดอย่างชัดเจน และ sticky note สีส้มก็หายากอย่างน่าประหลาดใจ 15
ต่อไป ผู้เข้าร่วมจะระบุคำสั่ง (command) ที่ทำให้เหตุการณ์เหล่านี้เกิดขึ้น Command คือการตัดสินใจของมนุษย์ (ผู้ใช้งานซอฟต์แวร์) ที่จะทำบางสิ่ง ตรงนี้คุณกำลังพยายามเข้าใจขอบเขตของระบบ และระบุตัวแสดง (actor) ที่เป็นมนุษย์ที่สำคัญในระบบ Commands ถูกบันทึกบน sticky note สีฟ้า
ฝ่ายเทคนิคในเซสชัน event storming ควรฟังสิ่งที่เพื่อนร่วมงานที่ไม่ใช่ฝ่ายเทคนิคคิดขึ้นมาในตรงนี้ ส่วนสำคัญของกิจกรรมนี้คือการไม่ปล่อยให้ implementation ปัจจุบันใด ๆ บิดเบือนการรับรู้ว่า domain คืออะไร (นั่นเป็นเรื่องทีหลัง) ในขั้นตอนนี้คุณต้องการสร้างพื้นที่ที่คุณสามารถดึงแนวคิดออกมาจากหัวของผู้มีส่วนได้ส่วนเสียหลักและนำออกมาเปิดเผยได้
เมื่อบันทึก events และ commands แล้ว ต่อไปคือ aggregates Events ที่คุณมีในขั้นตอนนี้ไม่เพียงมีประโยชน์ในการแบ่งปันว่าอะไรเกิดขึ้นในระบบเท่านั้น แต่ยังเริ่มชี้ให้เห็นว่า aggregate ที่เป็นไปได้อาจเป็นอะไรด้วย ลองนึกถึง domain event ที่กล่าวไปก่อนหน้านี้ "Order Placed" คำนามตรงนี้ "Order" อาจเป็น aggregate ที่เป็นไปได้ และ "Placed" อธิบายบางสิ่งที่สามารถเกิดขึ้นกับคำสั่งซื้อได้ ดังนั้นนี่อาจเป็นส่วนหนึ่งของ life cycle ของ aggregate นั้น Aggregates ถูกแสดงด้วย sticky note สีเหลือง และ commands กับ events ที่เกี่ยวข้องกับ aggregate นั้นจะถูกย้ายและจัดกลุ่มไว้รอบ ๆ aggregate นั้น สิ่งนี้ยังช่วยให้คุณเข้าใจว่า aggregates เกี่ยวข้องกันอย่างไร events จาก aggregate หนึ่งอาจกระตุ้นพฤติกรรมใน aggregate อื่นได้
เมื่อระบุ aggregates แล้ว พวกมันจะถูกจัดกลุ่มเข้าเป็น bounded contexts Bounded contexts โดยทั่วไปมักตามโครงสร้างองค์กรของบริษัท และผู้เข้าร่วมกิจกรรมนี้ก็อยู่ในตำแหน่งที่ดีที่จะเข้าใจว่า aggregates ใดถูกใช้โดยส่วนใดขององค์กร
ยังมีอะไรอีกมากมายเกี่ยวกับ event storming นอกเหนือจากที่ผมเพิ่งอธิบายไป นี่เป็นเพียงภาพรวมสั้น ๆ เท่านั้น สำหรับรายละเอียดเชิงลึกยิ่งขึ้นเกี่ยวกับ event storming ผมขอแนะนำให้อ่านหนังสือ (ที่กำลังเขียนอยู่ในขณะนี้) EventStorming โดย Alberto Brandolini (Leanpub) 16